Przykłady automatyzacji treści AI: 6 scenariuszy i które case studies to ściema
Przykład automatyzacji treści AI to konkretny scenariusz, w którym model językowy przejmuje jeden powtarzalny etap produkcji: research, draft, przekład albo publikację. Nie „wrzuciłem 1000 artykułów i mam ruch”. Jeden mierzalny kawałek roboty, który wcześniej klepałeś ręcznie.
Umówmy się od razu, bo o to w tym temacie chodzi najbardziej: większość „case studies z liczbami”, które krążą po LinkedInie i blogach dostawców, pokazuje szczyt i chowa upadek. Poniżej masz sześć scenariuszy, które faktycznie działają, rozbiór najgłośniejszej automatyzacji contentu, jaka spektakularnie się wywróciła, i pipeline, którym powstał ten artykuł. Chcesz szerszego kontekstu całej dziedziny? Zajrzyj do kompletnego przewodnika po automatyzacji contentu z AI. Tu jadę po konkretach.
Najważniejsze wnioski:
- Przykład automatyzacji to scenariusz co → jak → efekt na jednym etapie produkcji, nie masowa fabryka tekstu.
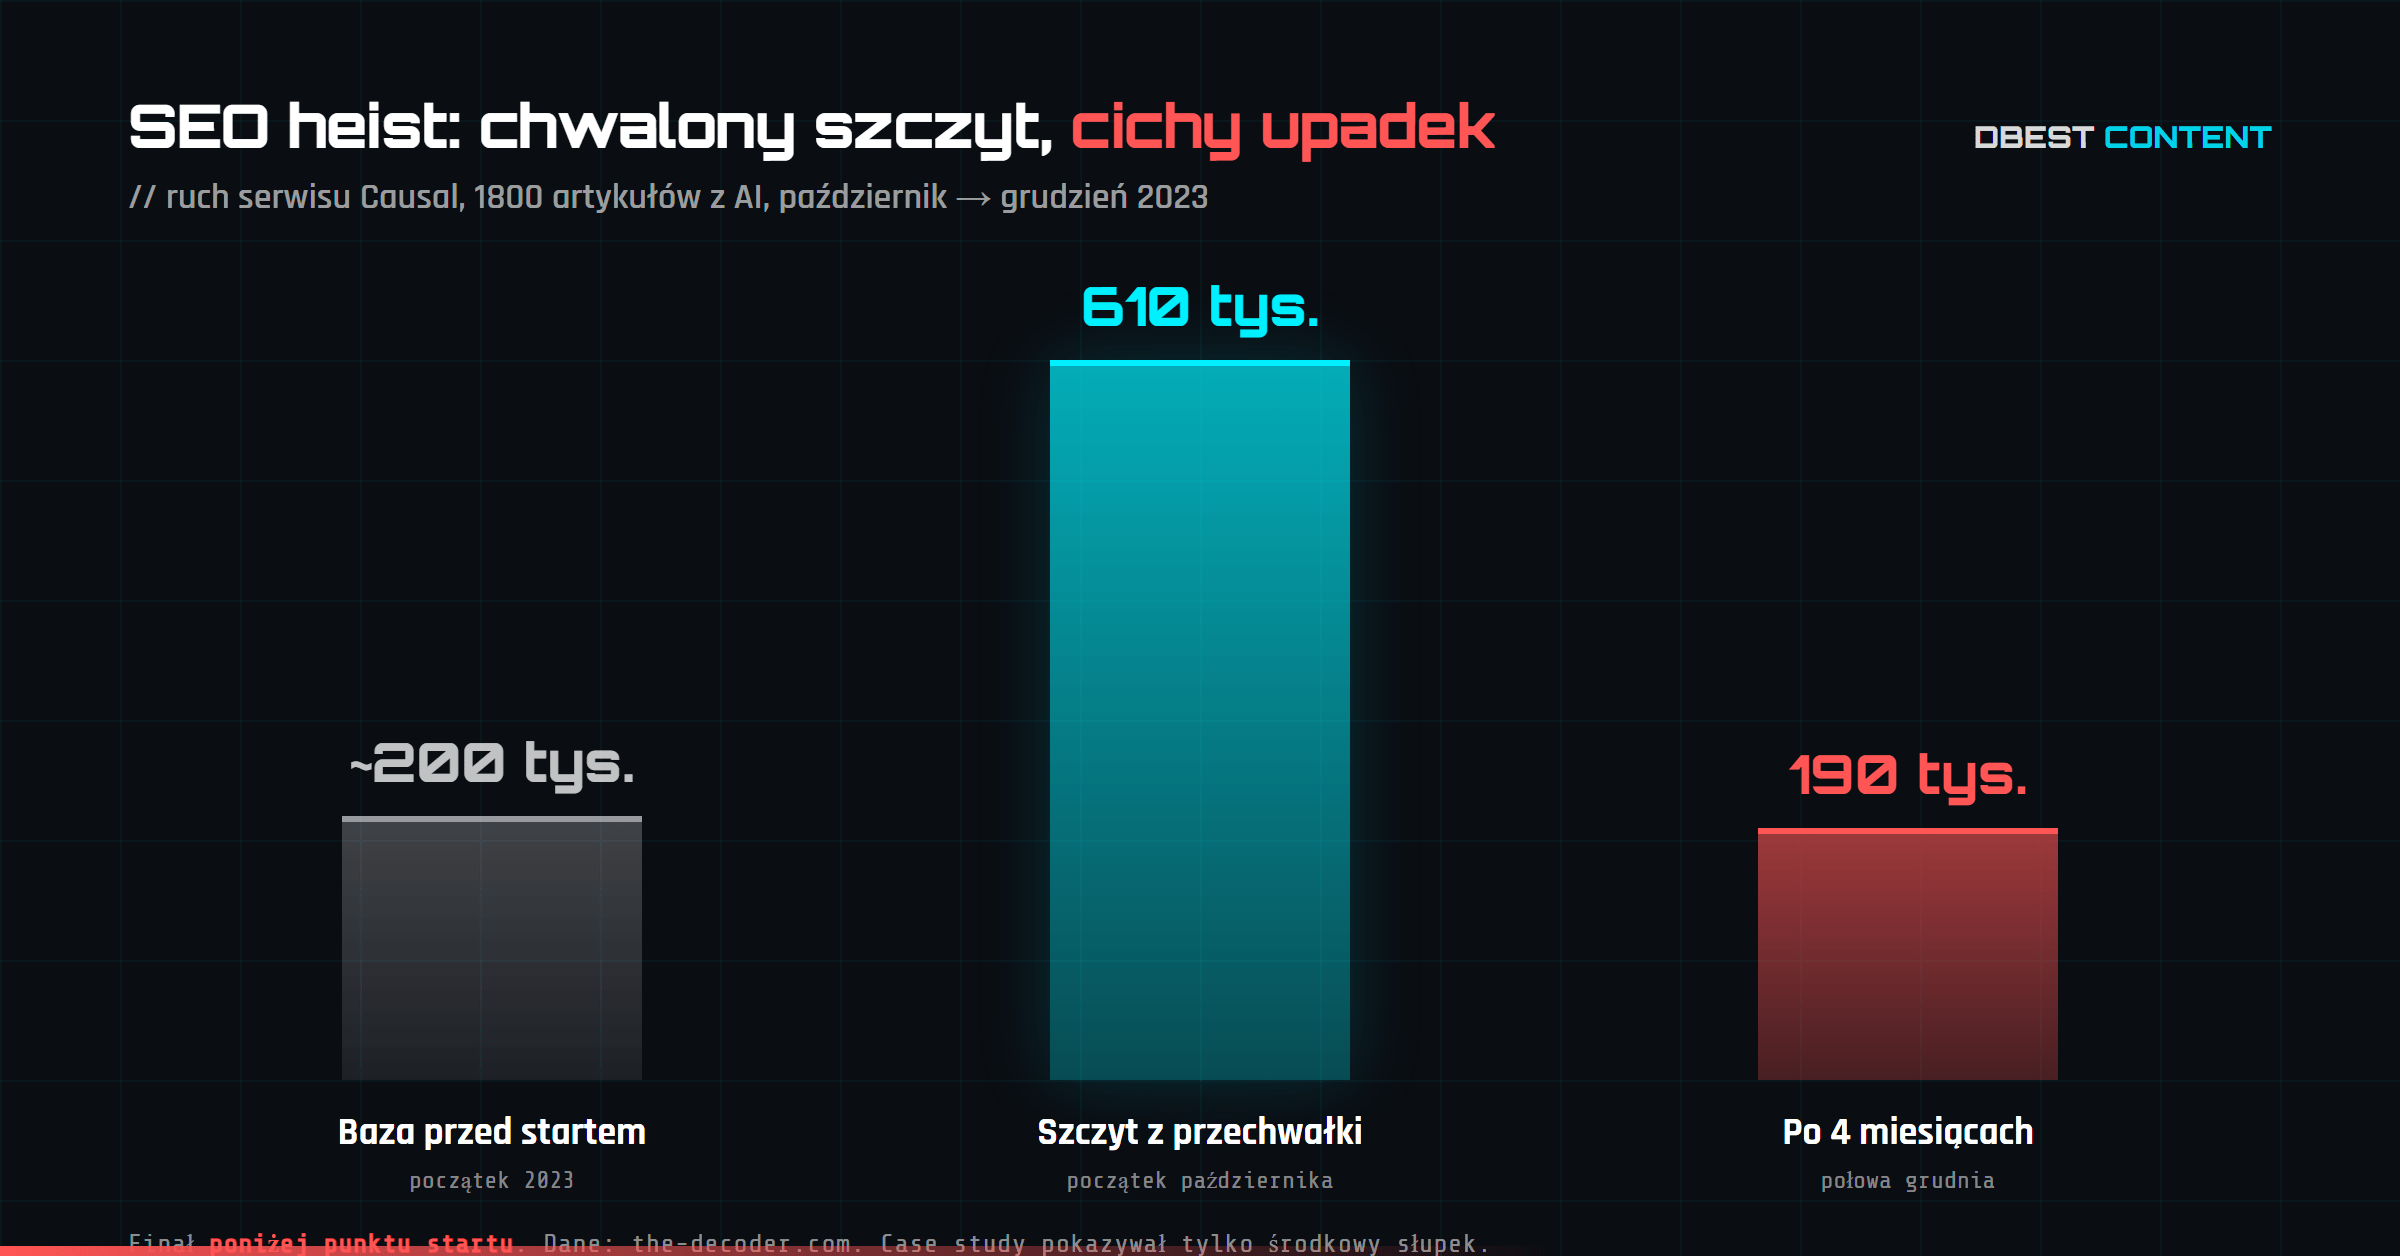
- SEO heist Jake’a Warda: 1800 artykułów z AI, chwalony szczyt 610 tys. wizyt, po 4 miesiącach spadek do 190 tys. – poniżej stanu sprzed startu.
- Case study z samym procentem, bez liczby bazowej („850% wzrostu”), to slajd sprzedażowy, a nie dowód.
- Google od 2024 roku karze masówkę pod ranking. Autor – model, człowiek czy miks – nie robi różnicy.
- Opisy produktów i repurposing automatyzujesz w całości. Tekst z opinią i danymi własnymi – research i draft tak, finisz ręcznie.
- Najuczciwszy przykład, jaki mogę ci dać, to system, którym powstał ten tekst – i pokazuję jego architekturę bez zmyślonych metryk.
Czym jest przykład automatyzacji treści AI, a czym nie jest
Automatyzacja treści AI oznacza, że model językowy przejmuje jeden albo kilka etapów produkcji, a ty spinasz je w powtarzalny przepływ pracy. Sensowny format to trójkąt: co automatyzujesz, jak to zrobione technicznie, jaki daje efekt. Bez tego trójkąta masz demo na konferencji, nie proces.
Rozróżnienie, na którym wykłada się połowa rynku, jest proste. Automatyzacja etapu to research pod artykuł odpalany jednym kliknięciem albo 400 opisów produktów wygenerowanych ze wzorca w noc. Fabryka tekstu to „napiszmy 5000 stron ze schematu i poczekajmy na ruch”. Pierwsze skaluje twoją robotę. Drugie skaluje twój problem.
Silnikiem każdego scenariusza jest model językowy, Claude albo GPT. Spoiwem jest narzędzie orkiestrujące, najczęściej n8n, które łączy kroki i integracje jak klocki. Reszta to detale konkretnego przypadku.
6 scenariuszy automatyzacji treści z AI, które działają w praktyce
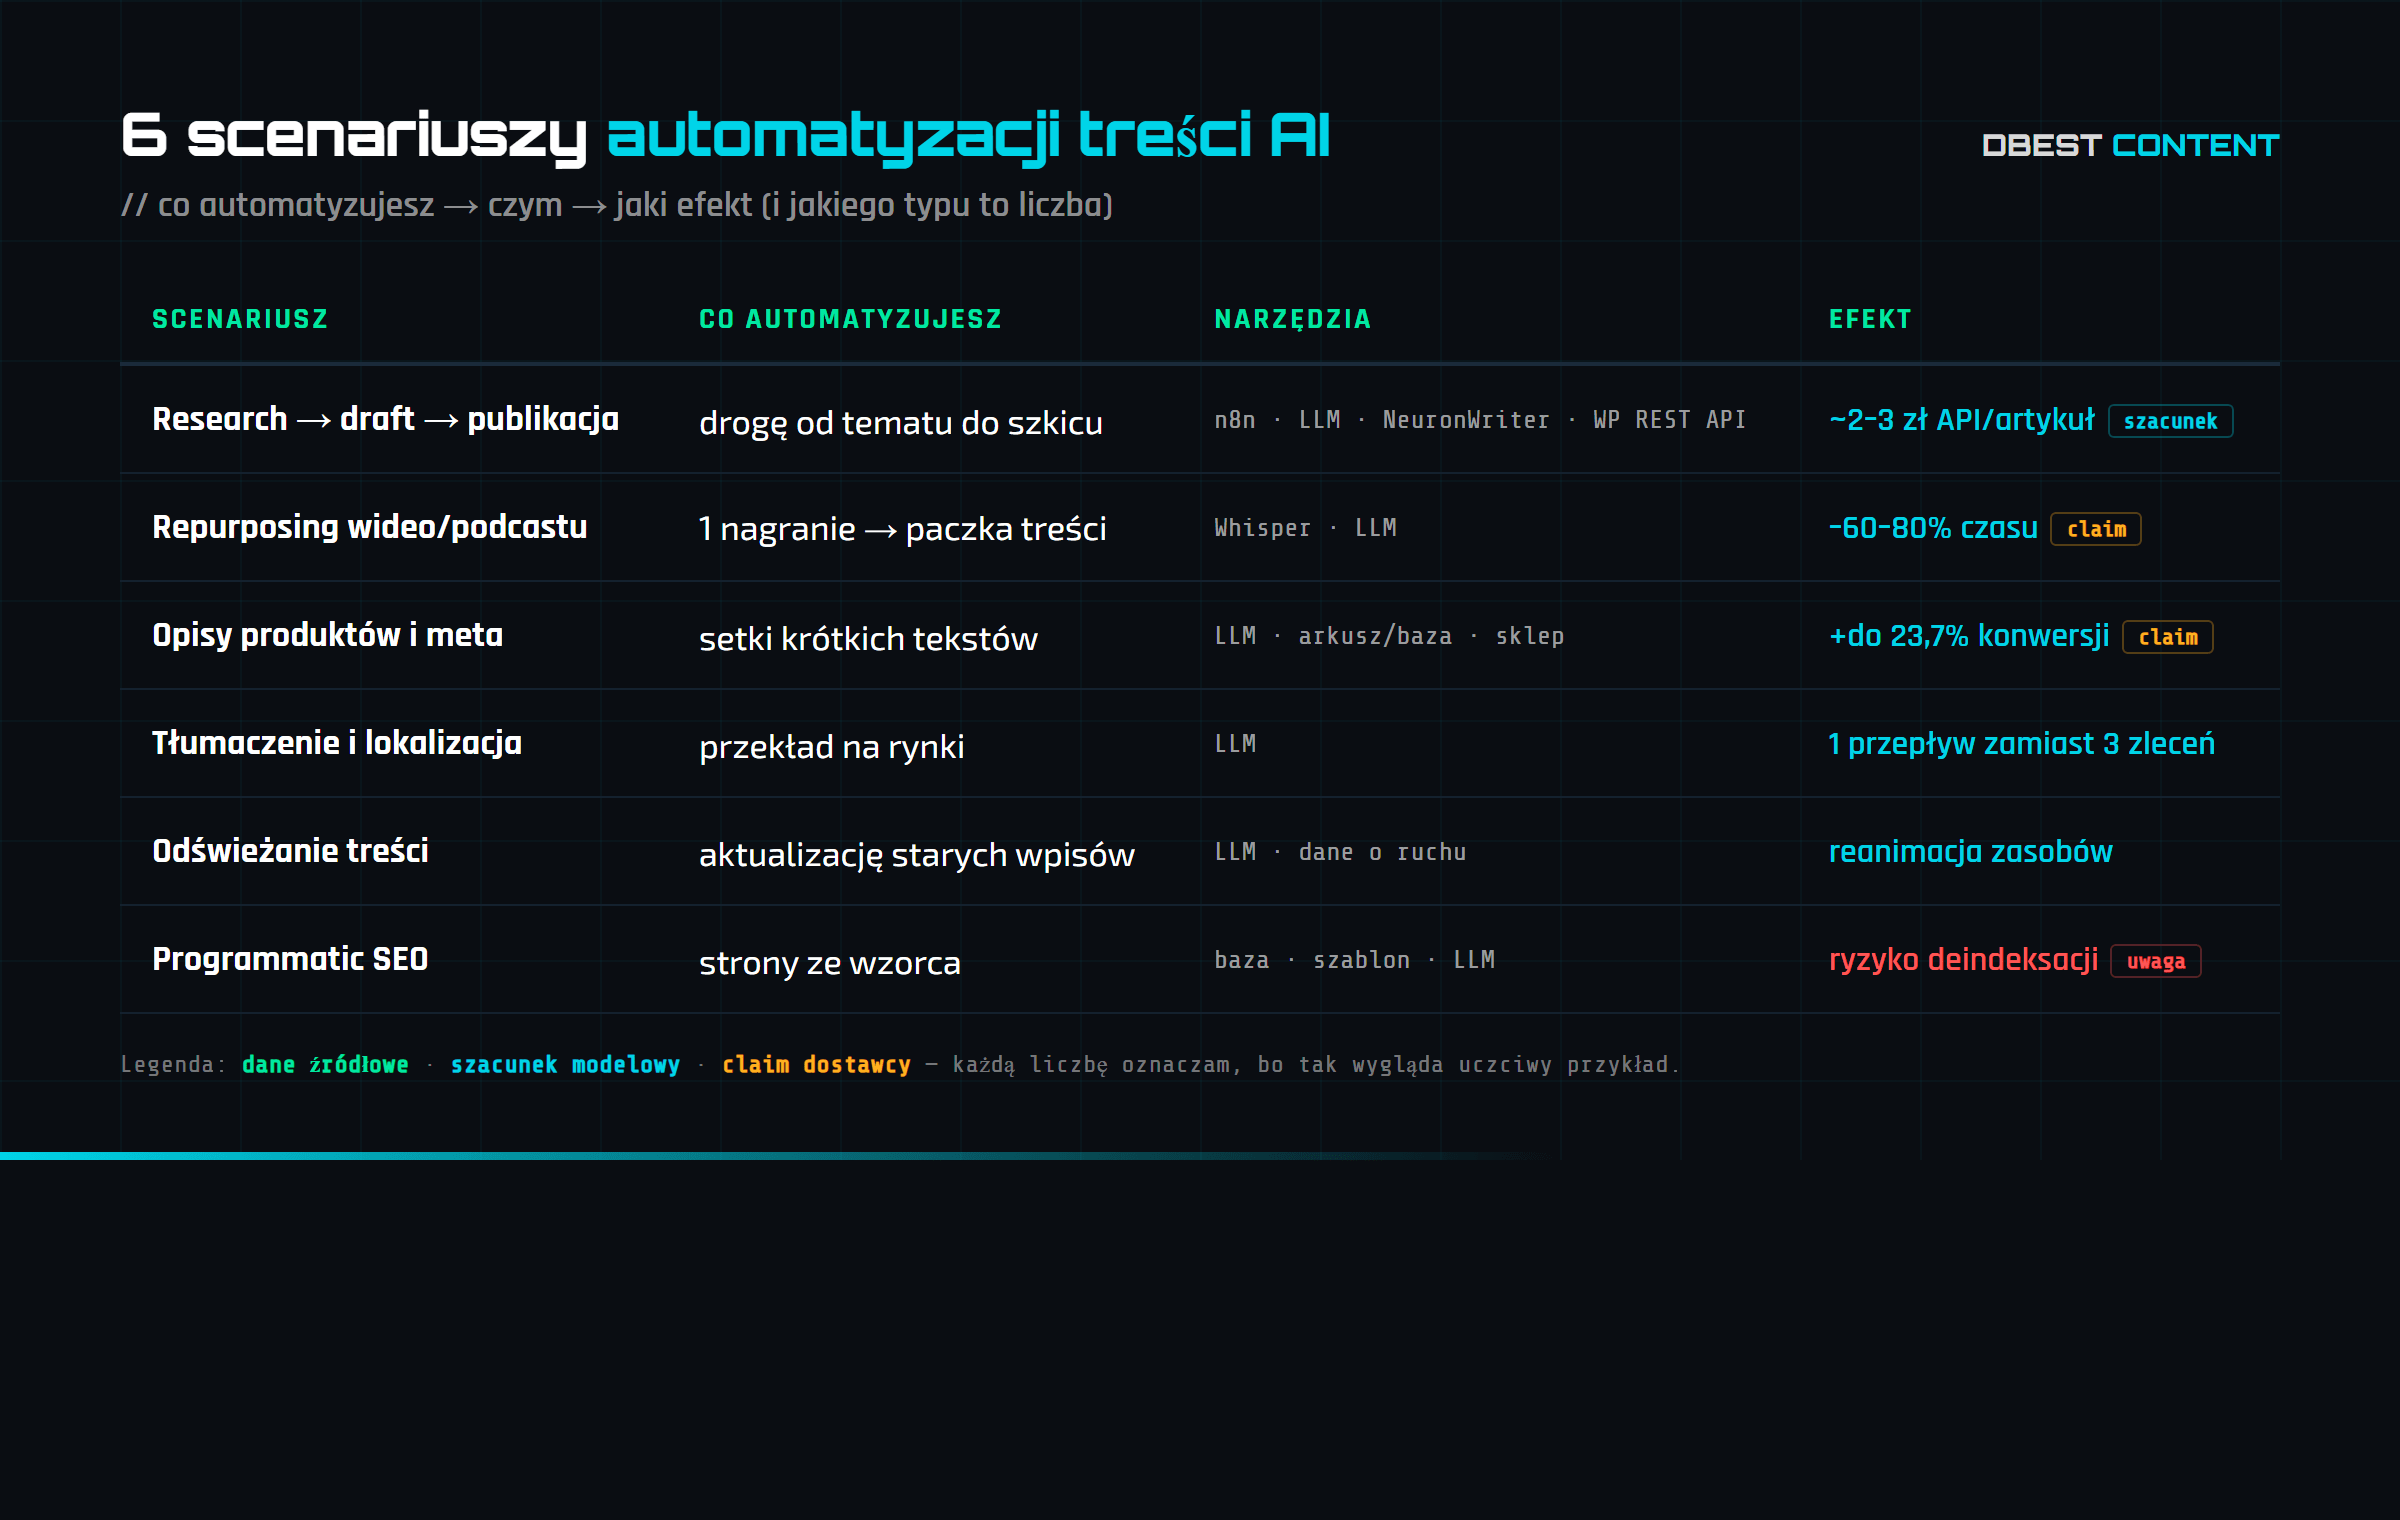
Poniżej sześć przykładów, które widuję u ludzi ogarniających temat i które sam stosuję. Przy każdej liczbie mam etykietę: dane źródłowe, szacunek albo claim dostawcy. Bo tak powinny wyglądać przykłady, a nie „efekt: kosmos”.
Scenariusz 1: research → draft → humanizacja → publikacja
Co automatyzujesz: całą drogę od tematu do wpisu roboczego w WordPressie. Jak: n8n odpala research w sieci, przekazuje wynik do modelu językowego, ten pisze draft pod strukturę z briefu, NeuronWriter sprawdza pokrycie semantyczne i content score, a WordPress REST API wrzuca gotowy szkic. Efekt: zamiast pół dnia klepania masz szkic w kilkanaście minut [szacunek], a tobie zostaje redakcja. Gotowe szablony takiego przepływu leżą na stronie n8n za darmo, choćby „Perplexity → GPT-4 → WordPress” [dane źródłowe]. Koszt API jednego artykułu to na miksie modeli jakieś 2–3 zł [szacunek modelowy] – całą arytmetykę rozbijam w tekście o tym, ile kosztuje automatyzacja contentu.
Scenariusz 2: repurposing wideo i podcastu na artykuł oraz posty
Co automatyzujesz: przerobienie jednego nagrania na paczkę treści. Jak: transkrypcja mową-na-tekst Whisperem, model wyciąga tezy i cytaty, z tego powstaje artykuł na bloga plus kilka postów na kanały. Efekt: repurposing tnie czas produkcji o 60–80% względem pisania od zera [claim agregatora, transcribetube.com]. To akurat scenariusz, w którym liczby są wiarygodne, bo mierzysz je u siebie – ten sam materiał, wiele kanałów, jeden koszt wejścia. Jak temat repurposingu jest dla ciebie nowy, mam osobny tekst o tym, czym jest content repurposing.
Scenariusz 3: masowe opisy produktów i meta w e-commerce
Co automatyzujesz: setki krótkich, powtarzalnych tekstów po szablonie. Jak: dane produktu z arkusza albo z bazy lecą do modelu, ten generuje opis, tytuł i meta description, a workflow wrzuca je do sklepu. Efekt: w badaniach opisy generowane AI podbijały konwersję do 23,7% [claim agregatora, describely.ai]. Powiem wprost – to najczystszy przypadek, w którym automatyzacja ma sens od pierwszego dnia. Nikt nie napisze ręcznie 2000 opisów lodówek z sercem, a model się przy tym nie nudzi.
Scenariusz 4: tłumaczenie i lokalizacja treści
Co automatyzujesz: przekład i dostosowanie tekstów na kolejne rynki. Jak: model tłumaczy artykuł albo opis, a dodatkowy krok dopasowuje ton i przykłady pod dany kraj. Efekt: bloga w trzech językach ogarniasz jednym przepływem, nie trzema zleceniami do biura tłumaczeń. Zastrzeżenie z praktyki: przekład marketingowy zawsze przejrzyj, bo model potrafi zgubić grę słów albo lokalny kontekst. To wciąż tania korekta zamiast pisania od nowa.
Scenariusz 5: odświeżanie starych treści
Co automatyzujesz: aktualizację artykułów, które kiedyś rankowały, a dziś więdną. Jak: workflow wybiera wpisy tracące ruch, model proponuje nowe sekcje, świeże dane i lepsze śródtytuły, a ty zatwierdzasz zmiany. Efekt: reanimujesz zasoby, które już masz, zamiast produkować kolejne. Robota nudna i powtarzalna, czyli w sam raz dla automatyzacji.
Scenariusz 6: programmatic SEO – z dużym ostrzeżeniem
Co automatyzujesz: generowanie wielu stron ze wzorca na własnych danych. Jak: baza danych plus szablon plus model, który wypełnia treść. Efekt bywa spektakularny – Flyhomes rozjechał serwis z 10 tys. do ponad 425 tys. stron w trzy miesiące [dane źródłowe, skala stron]. Tu stawiam czerwoną flagę. Programmatic SEO działa wyłącznie wtedy, kiedy każda strona niesie unikalne dane i konkretną wartość. Wygenerowana masówka bez wartości to prosta droga do deindeksacji, o czym za chwilę.
| Scenariusz | Co automatyzujesz | Narzędzia | Efekt (typ liczby) |
|---|---|---|---|
| Research → draft → publikacja | drogę od tematu do szkicu | n8n, LLM, NeuronWriter, WP REST API | ~2–3 zł API/artykuł (szacunek) |
| Repurposing wideo/podcastu | 1 nagranie → paczka treści | Whisper, LLM | –60–80% czasu (claim) |
| Opisy produktów i meta | setki krótkich tekstów | LLM, arkusz/baza, sklep | +do 23,7% konwersji (claim) |
| Tłumaczenie i lokalizacja | przekład na rynki | LLM | 1 przepływ zamiast 3 zleceń |
| Odświeżanie treści | aktualizację starych wpisów | LLM, dane o ruchu | reanimacja zasobów |
| Programmatic SEO | strony ze wzorca | baza + szablon + LLM | ryzyko deindeksacji |
Które case studies z liczbami to ściema, a które nie
Najgłośniejsza automatyzacja contentu z liczbami skończyła się deindeksacją. W kampanii nazwanej „SEO heist” Jake Ward wygenerował narzędziem Byword 1800 artykułów w kilka godzin, na podstawie zeskanowanej struktury konkurenta [dane źródłowe, 2023]. Chwalił się na X wynikiem 3,6 miliona wizyt i 13 tysiącami fraz na pierwszej stronie Google [claim autora]. Brzmi jak marzenie z reklamy kursu.
A teraz rzeczywistość. Ruch serwisu Causal spadł z 610 tysięcy wizyt na początku października do 190 tysięcy w połowie grudnia 2023, czyli poniżej bazy sprzed startu wynoszącej około 200 tysięcy [dane źródłowe, the-decoder.com]. Cała zabawa trwała jakieś cztery miesiące. Autor rzucił przy tym tekst, który świetnie oddaje mentalność branży od masówki: „AI jest mądrzejsze od 99% ludzi piszących te artykuły”. No i wyszło, jak wyszło.
To jest wzorzec ściemy w czystej postaci: pokazujesz szczyt, milczysz o dnie. Mało kto dopowiada, że case „850% wzrostu ruchu” to często wzrost ze 102 do 8,5 tysiąca wizyt [claim, omnius.so]. Procent brzmi jak petarda, a liczba bazowa zdradza, że mówimy o kilku tysiącach wejść. Do tego dochodzi błąd ocalałych – dostawca pokazuje ci trzy wygrane domeny, a nie setki wygaszonych, które poszły tą samą metodą i zniknęły.
Krótka piłka. Case study z liczbami jest wiarygodny, kiedy pokazuje trzy rzeczy naraz: liczbę bazową, horyzont czasowy i źródło danych. Brakuje którejś? Masz slajd sprzedażowy, a nie dowód. Ja takich liczb do własnych decyzji nie biorę i tobie odradzam.
Mój pipeline, którym powstał ten tekst
Najuczciwszy przykład automatyzacji, jaki mogę ci pokazać, to system, który właśnie czytasz w działaniu. Ten artykuł nie powstał od „napisz mi tekst o automatyzacji”. Przeszedł przez pipeline agenta blog-writer i pokazuję ci jego architekturę, a nie wymyślone metryki.
Kroki idą tak: research w sieci z zapisem źródeł, potem knowledge graph i analiza semantyczna, żeby ułożyć encje i relacje. Dalej outline z zaplanowanym information gain, czyli informacją, której nie ma w top 10. Potem draft pierwszej wersji. Następnie humanizacja osobnym skillem, bo surowy draft nosi ślady AI, które i tak bym wyłapał. Kolejny krok liczy pokrycie encji kodem – bramka przepuszcza tekst dopiero, gdy padły wszystkie encje, które paść powinny. Na końcu QA z twardymi bramkami: musi być sekcja FAQ, musi być informacja własna, muszą się zgadzać polskie cudzysłowy. Dopiero potem obrazek i publikacja przez WordPress REST API.
Stack roboczy: n8n self-host jako orkiestrator, NeuronWriter do warstwy semantycznej, model roboczy do draftu, a model topowy albo moja ręczna redakcja na finisz. Co mi to daje na co dzień, rozkładam w tekście o korzyściach z automatyzacji contentu. Sedno jest takie: automatyzacja nie wypycha mnie z procesu. Przejmuje nudną, powtarzalną robotę, a decyzje redakcyjne zostają u mnie.
Czy Google karze treści generowane przez AI
Google nie karze treści za to, że napisał je model. Karze masową produkcję pod ranking bez wartości dla czytelnika. Autor tekstu – model, człowiek czy miks obu – nie robi różnicy. To polityka scaled content abuse, wprowadzona w 2024 roku [dane źródłowe, developers.google.com]. Egzekwowanie ruszyło w tygodniu 5 marca 2024, a pełne wejście reguły przypadło na 5 maja 2024.
Zmiana jest ważna, bo przesuwa punkt ciężkości z narzędzia na intencję. Stara reguła mówiła o „treściach generowanych automatycznie”. Nowa mówi o celu: produkujesz strony głównie po to, żeby manipulować wynikami? Ryzykujesz, choćby każdą literę wystukał człowiek.
Dlatego scenariusze z tego artykułu są bezpieczne, a fabryka tekstu nie. Opis produktu, który faktycznie pomaga kupującemu, jest w porządku. Artykuł z twoimi danymi i opinią jest w porządku. Pięć tysięcy pustych stron ze wzorca to proszenie się o deindeksację. Widać to zresztą po całym rynku – jak konkurencja podchodzi do AI z głową, opisuję w tekście o tym, że twoja konkurencja już używa AI.
Kiedy automatyzować treść, a kiedy tego nie tykać
Zdecyduj po charakterze treści, nie po tym, co obiecał dostawca narzędzia. Trzymaj się trzech reguł, a oszczędzisz sobie wtopy.
Jeśli treść jest powtarzalna i szablonowa, jak opisy produktów, meta description czy proste aktualizacje – automatyzuj ją w całości i nie oglądaj się za siebie. Tu człowiek dokłada nudę, nie wartość. Jeśli treść niesie opinię, dane własne albo ekspercką ocenę, jak ten artykuł – automatyzuj research i draft, ale finisz zrób ręcznie, bo to twoja wiarygodność idzie pod tekstem. A jeśli kusi cię, żeby wygenerować tysiąc stron ze wzorca i poczekać na ruch – odpuść, bo skończysz jak Causal, tylko bez rozgłosu.
Najpierw ustaw sobie pomiar, potem odpalaj cokolwiek na produkcji. Inaczej nie odróżnisz scenariusza, który dowozi, od takiego, który tylko wygląda efektownie – jak to zmierzyć, rozpisuję w tekście o tym, jak mierzyć efekty automatyzacji contentu.
Przykłady automatyzacji treści AI: najczęstsze pytania
Jakie są najczęstsze przykłady automatyzacji treści AI?
Najczęstsze przykłady to sześć powtarzalnych scenariuszy: pipeline research → draft → publikacja, repurposing wideo i podcastu, masowe opisy produktów, tłumaczenie i lokalizacja, odświeżanie starych treści oraz programmatic SEO. Każdy automatyzuje jeden etap produkcji, a nie całą fabrykę tekstu. Silnikiem jest model językowy, spoiwem najczęściej n8n.
Czego uczy case study SEO heist Jake’a Warda?
SEO heist uczy, że masowa generacja treści pod ranking daje krótki skok i długi upadek. Ward wygenerował 1800 artykułów, chwalił się 3,6 milionami wizyt, a serwis Causal spadł z 610 do 190 tysięcy wizyt w cztery miesiące, poniżej stanu sprzed kampanii. Morał: patrz na horyzont i liczbę bazową, nie na szczyt z przechwałki.
Czy Google karze treści generowane przez AI?
Google karze masową produkcję treści pod ranking bez wartości, nie samo użycie AI. Polityka scaled content abuse z 2024 roku liczy cel publikacji, a nie autora, więc obejmuje teksty z modelu, od człowieka i miks. Treść, która pomaga czytelnikowi, jest bezpieczna, obojętne jak powstała.
Jak wygląda pipeline automatyzacji treści w n8n?
Pipeline w n8n łączy kroki jak klocki: węzeł researchu w sieci, węzeł wywołania modelu językowego, węzeł optymalizacji semantycznej i węzeł publikacji przez WordPress REST API. n8n rozlicza wykonania workflow, nie pojedyncze akcje, dzięki czemu wychodzi taniej niż narzędzia z modelem per-task. Gotowe szablony takich przepływów są dostępne za darmo na stronie n8n.
Które treści opłaca się automatyzować, a których nie?
Opłaca się automatyzować treści powtarzalne i szablonowe: opisy produktów, meta description, tłumaczenia i aktualizacje. Nie opłaca się w pełni automatyzować tekstów opartych na opinii i danych własnych – tam automatyzujesz research i draft, a finisz robisz ręcznie. Masowe strony ze wzorca bez wartości odpuść całkiem, bo ryzykujesz deindeksację.
Jak odróżnić wiarygodny case study automatyzacji od ściemy?
Wiarygodny case study podaje liczbę bazową, horyzont czasowy i źródło danych naraz. Ściema pokazuje sam procent wzrostu albo sam szczyt ruchu, bez punktu wyjścia i bez ciągu dalszego. Dodatkowy sygnał ostrzegawczy to błąd ocalałych – dostawca chwali się wygranymi, milczy o wygaszonych domenach zrobionych tą samą metodą.
Ile czasu oszczędza repurposing treści z AI?
Repurposing treści z AI tnie czas produkcji o 60–80% względem tworzenia każdego materiału od zera, według danych agregatorów rynkowych. Oszczędność jest tu wiarygodna, bo mierzysz ją u siebie: to samo nagranie zasila artykuł i kilka postów przy jednym koszcie wejścia. To jeden z niewielu scenariuszy, w którym liczby ze studiów przypadku łatwo potwierdzić własnym przykładem.
Zamiast klamry: zrób to na jednym scenariuszu
Nie odpalaj sześciu przepływów naraz. Weź jeden powtarzalny etap, który zjada ci najwięcej czasu, zautomatyzuj go porządnie i zmierz efekt, a dopiero potem ruszaj dalej. Reszta poczeka.
Jeśli chcesz przejść od czytania do wdrożenia w swojej firmie, na szkoleniach z AI dla firm zaczynam od audytu twoich procesów, a agendę dobieram pod to, gdzie faktycznie tracicie czas, nie odwrotnie. Bo automatyzacja bez zmapowanego procesu to najdroższy sposób na produkowanie tego samego bałaganu szybciej.