Ograniczenia AI w content marketingu: czego automat nie ogarnie
Automatyzacja contentu z AI ma twarde granice, a przekroczenie ich kosztuje ranking albo wiarygodność marki. Ograniczenia AI w content marketingu to nie strach sceptyków, tylko lista miejsc, w których automat produkuje śmieci zamiast wartości. Znam te miejsca z praktyki, bo automatyzuję content na co dzień – na n8n, NeuronWriterze i modelach językowych. Dlatego mówię wprost, czego temu automatowi nie oddaję. Pełny obraz razem z oszczędnościami masz w tekście o automatyzacji contentu z AI, a tutaj dostajesz drugą stronę bilansu.
Ten tekst jest antytezą artykułu o korzyściach z automatyzacji contentu. Uczciwy przegląd tego, gdzie się wykłada, z ręki kogoś, kto na tym zarabia.
Najważniejsze wnioski:
- halucynacje AI zależą od typu zadania: model zmyśla w 40–80% przy pisaniu od zera, ale poniżej 2% przy streszczaniu z podanego źródła,
- automat skaluje ilość, nie jakość, więc masowa produkcja z AI mnoży thin content, a Google karze to spadkami ruchu rzędu 50–80%,
- doświadczenie z pierwszej ręki i własna opinia to jedyne trwałe źródło przewagi, którego model nie dostarczy,
- YMYL, czyli zdrowie, pieniądze i prawo, to twarda granica, za którą automat bez człowieka uderza w portfel albo w zdrowie,
- „ustaw i zapomnij” to mit; workflow dryfuje i pęka, a utrzymanie go to stała pozycja w budżecie,
- sensowny model to human-in-the-loop: automat robi 80% roboty, która nie jest wartością, a 20%, które jest wartością, robisz sam.
Gdzie automatyzacja contentu się wykłada
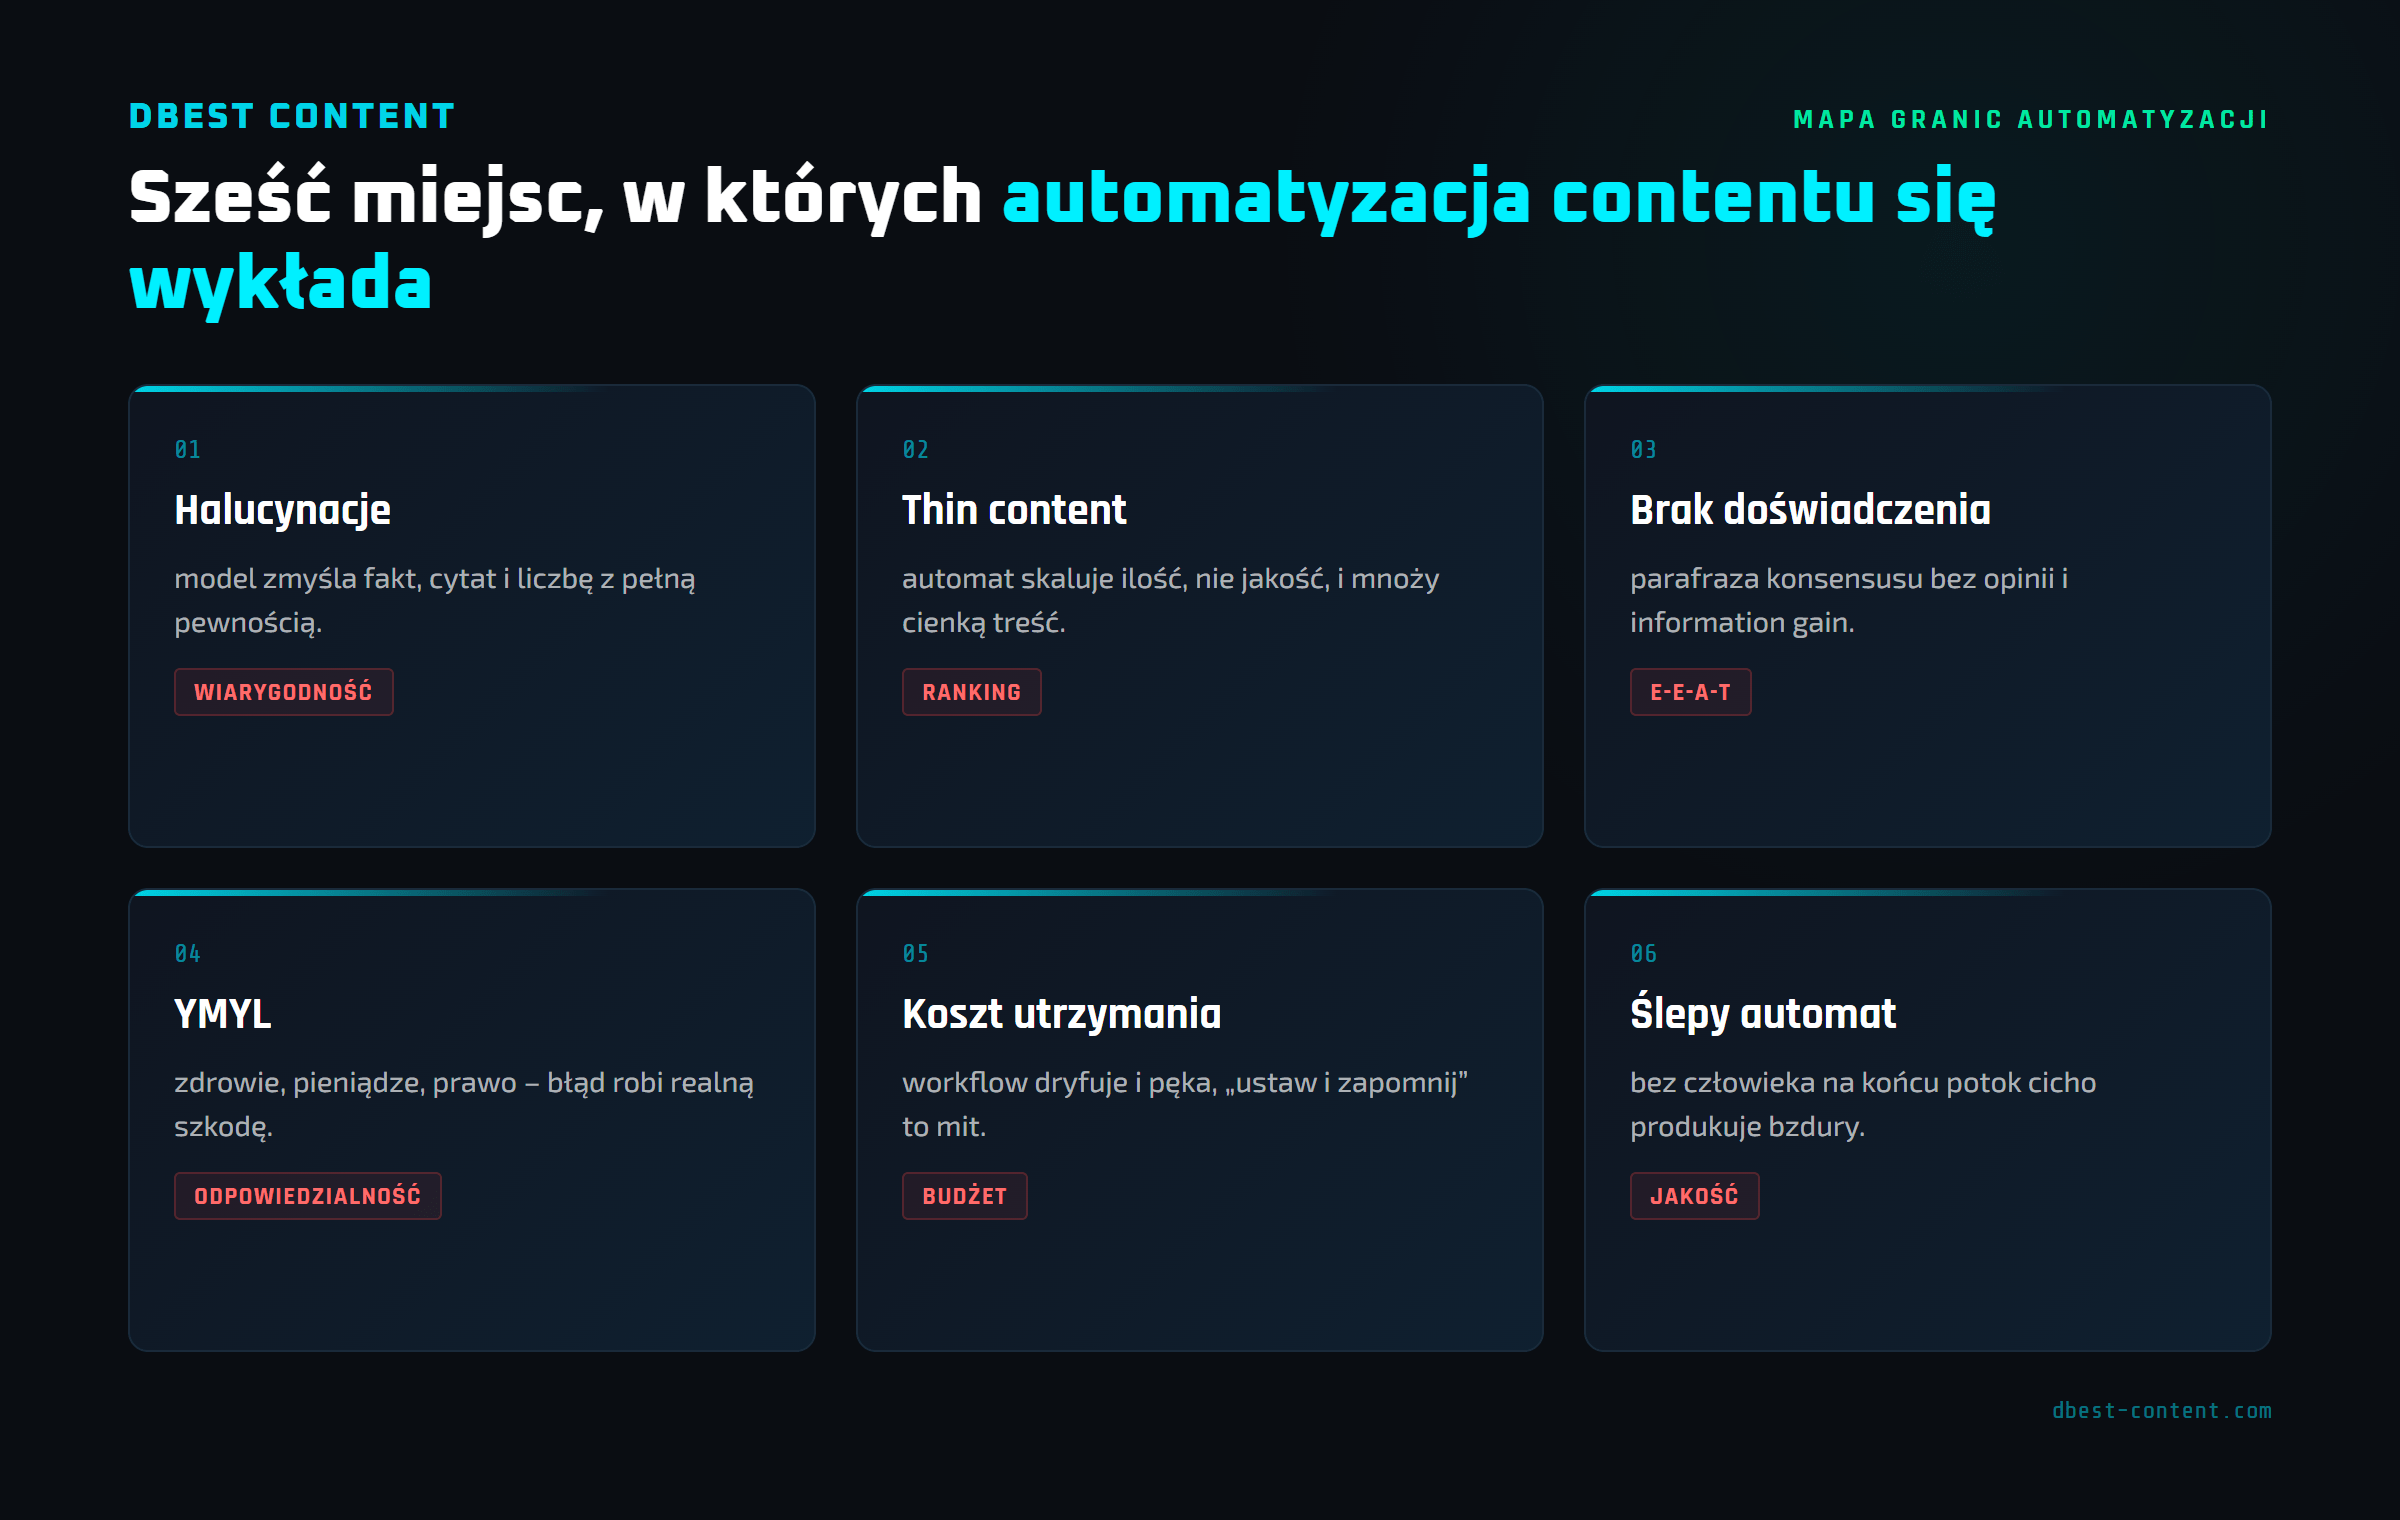
Automatyzacja contentu z AI wykłada się w sześciu miejscach naraz: na halucynacjach, na thin contencie, na braku własnego doświadczenia, na tematach YMYL, na koszcie utrzymania i na złudzeniu „ustaw i zapomnij”. Każde uderza w inną warstwę. Jedne psują wiarygodność, inne ranking, jeszcze inne budżet. Traktuj tę szóstkę jak mapę min, nie jak argument przeciw automatyzacji.
Umówmy się co do jednego. Nie piszę tego, żeby cię odstraszyć od AI, bo strzelałbym wtedy do własnej nogi. Piszę, żebyś wiedział, gdzie postawić człowieka, a gdzie spokojnie puścić maszynę. Każdy obszar niżej dostaje diagnozę i granicę.
Halucynacje AI, czyli zmyślony fakt podany z pewnością
Halucynacja AI to sytuacja, w której model językowy podaje zmyślony fakt, cytat albo liczbę z taką samą pewnością jak prawdziwy. Ryzyko nie jest stałe. Zależy od typu zadania: przy generowaniu treści od zera modele halucynują w 40–80% odpowiedzi, przy zamkniętym pytaniu z podanym kontekstem spada to do 10–20%, a przy streszczaniu zakotwiczonym w źródle schodzi poniżej 2%. Najgorzej wygląda generowanie cytatów i źródeł, gdzie w zadaniach prawniczych halucynacje sięgają 58–88%. Model nie umie powiedzieć „nie wiem”, więc w miejsce brakującej wiedzy wstawia coś, co brzmi wiarygodnie.
Stąd bierze się moja robocza zasada, której mało kto pilnuje: model zmyśla najmniej wtedy, kiedy przepisuje z tego, co mu dasz, a najwięcej wtedy, kiedy sam dopowiada fakty. To jest bezpieczna strefa modelu. Streszczenie briefu, przeformułowanie akapitu, uporządkowanie notatek z researchu, który sam zebrałeś – tu ryzyko jest minimalne. Twierdzenie z liczbą, statystyka, nazwisko, data, sygnatura wyroku, cena, cytat – tu model zgaduje.
| Typ zadania | Przykład | Ryzyko halucynacji |
|---|---|---|
| streszczenie z podanego źródła | skrót raportu, który wklejasz | poniżej 2% |
| zamknięte pytanie z kontekstem | odpowiedź na bazie dokumentu | 10–20% |
| generowanie treści od zera | artykuł z samego promptu | 40–80% |
| generowanie cytatów i źródeł | „podaj badania na temat X” | 58–88% |
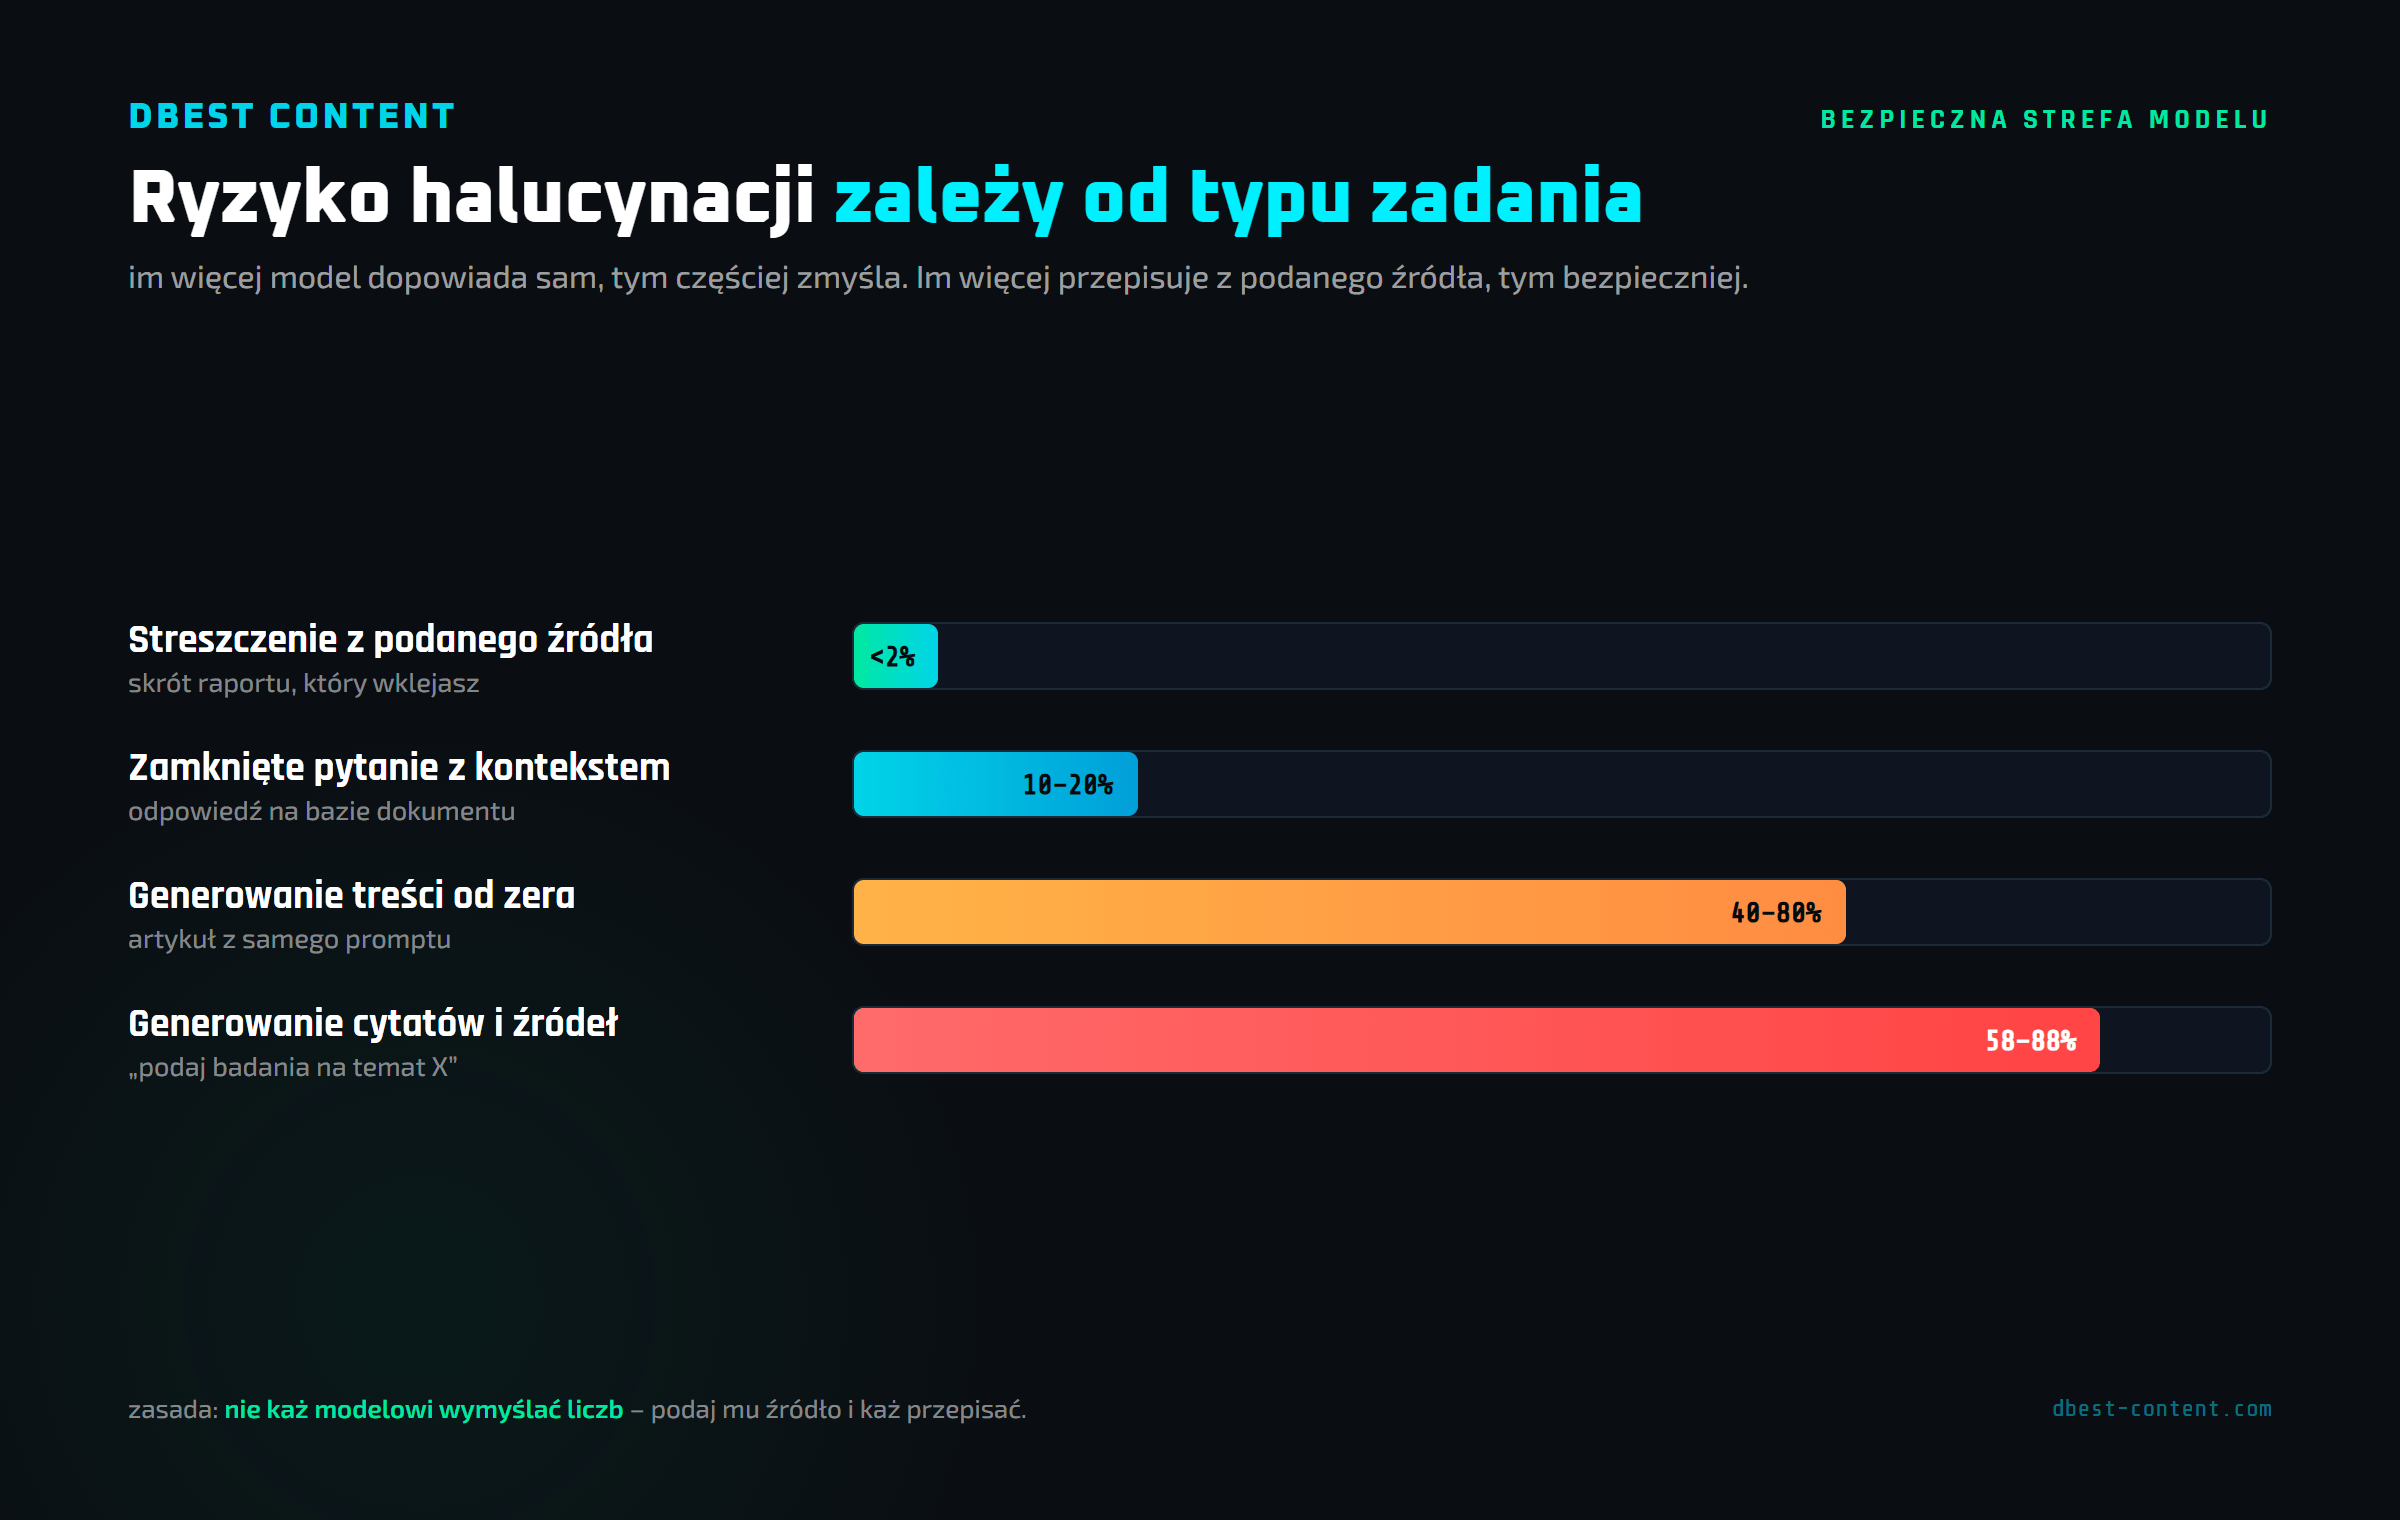
Co z tego masz? Nie każ modelowi wymyślać liczb. Jeżeli tekst potrzebuje statystyki, znajdź ją sam, podaj modelowi i każ przepisać z atrybucją. Ja żadnego twierdzenia z liczbą nie puszczam dalej, dopóki nie zobaczę źródła na własne oczy. I jeszcze jedno, wbrew intuicji: mocniejsze modele rozumujące potrafią dryfować bardziej na złożonych zadaniach, więc „lepszy model” nie kasuje problemu, tylko go przesuwa.
Fabryka thin contentu, którą Google już filtruje
Thin content to treść, która nie wnosi nic ponad to, co już jest w wynikach wyszukiwania. Automat produkuje ją hurtowo, bo skaluje ilość, nie jakość. Wrzucasz jeden prompt, dostajesz sto artykułów, i wszystkie sto to przepisany konsensus z pierwszych pozycji Google. Skalujesz cienkie, więc skalujesz problem. Google nazwał ten mechanizm scaled content abuse, czyli generowanie wielu stron głównie po to, żeby manipulować rankingiem, bez wartości dla czytelnika – i w marcowym rdzeniowym uaktualnieniu z 2026 roku zdjął za to ruch w skali 50–80%, a farmom treści nawet 45–65%.
Teraz kontra-fakt, który psuje panikę „internet zalała AI”. Według badania Graphite na 65 000 artykułów 52% nowych publikacji w sieci powstaje z AI, ale w wynikach wyszukiwania Google jest ich tylko 14%. Google już filtruje slop. Połowa produkcji ląduje w cyfrowym rowie, do którego nikt nie zagląda. Jeżeli twoja strategia to „wygenerujemy dużo i coś się przebije”, właśnie zobaczyłeś, ile się przebija.
Mam na to prosty test, który stosuję do każdego wygenerowanego tekstu. Usuń wszystkie zdania, które równie dobrze napisałby twój konkurent z tego samego promptu. Zobacz, co zostaje. Jeżeli zostaje pusta strona, masz thin content, choćby liczył trzy tysiące słów. Jeżeli zostaje opinia, liczba z własnego testu albo obserwacja, której nie ma nigdzie indziej, masz tekst wart publikacji. Ta sama logika stoi za tym, że Google odróżnia teksty człowieka od maszynowych, co rozkładam w przewodniku po tym, jak rozpoznać tekst z AI.
Powiem to bez owijania: fabryka contentu na AI to najgłupszy sposób użycia dobrego narzędzia, jaki widziałem. Bierzesz maszynę, która potrafi skrócić ci research o połowę, i każesz jej robić coś, za co Google cię ukarze.
Brak własnego doświadczenia i opinii, czyli granica E-E-A-T
Model językowy nie ma doświadczenia, opinii ani anegdoty, bo nie żył – tylko przeczytał. Parafrazuje konsensus, czyli uśrednia to, co już napisali inni. Google ocenia treść między innymi przez E-E-A-T, gdzie pierwsze „E” oznacza Experience, czyli doświadczenie z pierwszej ręki. To jest dokładnie ten element, którego automat nie dostarczy, bo nie da się przeczytać cudzego doświadczenia i podać go jako własne. Oryginalne dane i przykłady z własnej roboty podnoszą widoczność, a przepisany konsensus ją traci.
Tu leży sedno różnicy między AI a człowiekiem w pisaniu, którą rozbieram osobno w tekście o AI kontra człowiek w copywritingu. Człowiek wnosi information gain, czyli to, czego nie ma w wynikach: własny wynik testu, wpadkę z projektu, liczbę z faktury, obserwację ze współpracy.
Powiem, jak dzielę robotę u siebie, bo to konkret, nie teoria. Automatowi oddaję research, szkielet tekstu, przepisanie z briefu, dystrybucję i przerabianie jednego materiału na wiele formatów. Zostawiam sobie opinię, anegdotę, twierdzenie z liczbą, które muszę potwierdzić, i finalną redakcję. Mało kto wie, że w moim własnym procesie pisania artykułów model nie dotyka ani jednej samodzielnej liczby i ani jednego zdania, które ma nieść moje zdanie. Reguła, która mi to porządkuje, brzmi prosto: automat robi 80% roboty, która sama w sobie nie jest wartością, a 20%, które jest wartością, robię sam.
Widać to najlepiej na głosie marki. Model ciągnie każdy tekst do średniej, bo średnia to jego natura statystyczna. Puść dziesięć marek przez ten sam automat, a dostaniesz dziesięć tekstów brzmiących, jakby napisał je jeden komitet algorytmów. Wyróżnik marki, ten twój konkretny sposób mówienia, znika pierwszy.
YMYL i tematy regulowane, czyli twarda granica automatyzacji
YMYL to skrót od „Your Money or Your Life”, czyli tematy dotyczące zdrowia, pieniędzy, prawa i bezpieczeństwa, gdzie błąd w tekście szkodzi czytelnikowi wprost. Tu automat bez człowieka na końcu to najkrótsza droga do kłopotu. Zmyślona liczba w artykule o suplementach, o odliczeniu podatku albo o zakresie polisy nie jest literówką – to szkoda dla kogoś, kto ci zaufał. Google trzyma na tych tematach najwyższą poprzeczkę jakości, bo sam wie, ile kosztuje błędna porada zdrowotna czy finansowa.
Pisałem contenty dla marek ubezpieczeniowych, między innymi dla Market Ubezpieczeń i PKO Ubezpieczenia, i wiem z tej roboty jedno: jedno zdanie za dużo o „gwarantowanej wypłacie” potrafi wejść w konflikt z zapisami ogólnych warunków umowy. Model tego kontekstu nie zna. On zna słowa, które statystycznie chodzą razem, więc dopisze ci „pełną ochronę” i „całkowite bezpieczeństwo” tam, gdzie prawnik dostaje palpitacji.
Moja granica jest tu ostra. Tematy regulowane może wspierać automat na etapie researchu i szkieletu, ale każde twierdzenie przechodzi przez człowieka, który zna temat i odpowiada za skutki. Nie potrafisz zweryfikować, czy liczba w tekście o zdrowiu jest prawdziwa? Taki temat nie idzie do automatu. Kropka.
Koszt utrzymania, czyli dlaczego „ustaw i zapomnij” to mit
Automatyzacja contentu nie jest jednorazowym ustawieniem, tylko żywym organizmem, który musisz karmić i naprawiać. „Ustaw i zapomnij” brzmi świetnie na landingu sprzedawcy narzędzia. W praktyce workflow pęka, gdy tylko zmieni się coś po drugiej stronie. Notion zmienia API, twój przepływ staje. Airtable zmienia autoryzację, staje. Slack modyfikuje format webhooka, staje. Do tego dochodzi automation entropy, czyli powolny rozpad: modele są niedeterministyczne, więc drobna zmiana formatu danych na wejściu albo cicha aktualizacja modelu sprawia, że potok dryfuje albo pada po cichu, a ty dowiadujesz się o tym z opóźnieniem.
Policzmy, bo tu ludzie robią sobie krzywdę optymizmem. Pojedynczy workflow w n8n zjada 30–60 minut utrzymania miesięcznie, a przy złożonych integracjach więcej. Do tego opłaty za API modeli, które przy większym wolumenie idą w setki, nie w grosze. Największy ukryty koszt to nie tokeny. To czas człowieka na wyłapanie momentu, w którym automat zaczął produkować bzdury z uśmiechem.
Dlatego najpierw robię audyt procesu, a dopiero potem ktokolwiek wpina w niego AI – i dokładnie tak wygląda punkt wyjścia moich szkoleń z AI dla firm, gdzie agenda powstaje po audycie, a nie odwrotnie. Automatyzujesz proces, który rozumiesz, albo automatyzujesz swój bałagan i płacisz za to dwa razy. Koszt utrzymania wpisz do budżetu jako stałą pozycję, obok kosztu wdrożenia, bo inaczej twój zwrot z automatyzacji jest fikcją na papierze.
Co automatyzować, a czego nie tykać
Sensowny model pracy z AI w contencie to human-in-the-loop, czyli człowiek jako część systemu, a nie jego widz. Masz niżej reguły decyzyjne, które stosuję sam, wprost do wykonania.
Jeżeli zadanie polega na przepisaniu albo streszczeniu z gotowego źródła, oddaj je automatowi bez wahania – to bezpieczna strefa modelu i marnujesz tam czas człowieka. Jeżeli tekst niesie twierdzenie z liczbą w temacie YMYL, nie puszczaj go bez człowieka, który tę liczbę potwierdzi i weźmie za nią odpowiedzialność. Jeżeli wartością tekstu ma być opinia, doświadczenie albo głos marki, napisz sam, a AI najwyżej uporządkuje ci strukturę. Jeżeli skalujesz produkcję treści, skaluj w tym samym tempie redakcję, bo inaczej skalujesz thin content i płacisz za własną karę od Google. Jeżeli twój workflow działa bezawaryjnie od miesięcy, i tak przejrzyj go co jakiś czas, bo dryfuje po cichu i pewnego dnia zobaczysz to na wynikach, nie w alercie.
| Zadanie | Kto robi | Dlaczego |
|---|---|---|
| research i zbieranie źródeł | automat, człowiek sprawdza | model przyspiesza, ale zmyśla źródła |
| szkielet i struktura tekstu | automat | niskie ryzyko, duża oszczędność czasu |
| przepisanie z briefu | automat | bezpieczna strefa modelu |
| twierdzenie z liczbą | człowiek | halucynacje i odpowiedzialność |
| opinia, anegdota, głos marki | człowiek | information gain, którego AI nie da |
| tematy YMYL | człowiek decyduje, automat wspiera | szkoda dla czytelnika przy błędzie |
| finalna redakcja | człowiek | łapie dryf i thin content |
Ten podział nie jest kompromisem z lenistwa. To sposób, w jaki wyciskasz z AI to, co robi dobrze, i odcinasz to, co robi źle. Więcej o wpinaniu modelu w konkretne etapy pracy rozkładam w tekście o tym, jak wpiąć AI w workflow contentowy.
Ograniczenia AI w content marketingu: najczęstsze pytania
Czego AI nie potrafi w content marketingu?
AI nie potrafi wnieść własnego doświadczenia, opinii ani information gain, bo parafrazuje istniejący konsensus zamiast tworzyć nowe obserwacje. Nie powie też „nie wiem”, więc w miejsce brakującej wiedzy wstawia halucynacje. Ostatecznie nie bierze odpowiedzialności za skutki tekstu, co wyklucza samodzielną pracę na tematach YMYL.
Czy Google karze treści generowane przez AI?
Google nie karze za sam fakt użycia AI, tylko za masową produkcję stron bez wartości, którą nazywa scaled content abuse. W marcowym rdzeniowym uaktualnieniu z 2026 roku strony publikujące setki tekstów AI bez redakcji straciły 50–80% ruchu. Dobrze zredagowana treść z AI, która niesie wartość, rankuje normalnie.
Czym są halucynacje AI i jak groźne są w tekstach?
Halucynacja to zmyślony przez model fakt, cytat albo liczba podana z pełną pewnością. Groźność zależy od zadania: przy generowaniu od zera model myli się w 40–80% przypadków, a przy streszczaniu z podanego źródła poniżej 2%. Najgroźniejsze są zmyślone statystyki i źródła, bo brzmią wiarygodnie i przechodzą przez niedbałą redakcję.
Czy można zautomatyzować teksty o zdrowiu, prawie i finansach?
Tematy YMYL można wspierać automatem tylko na etapie researchu i szkieletu, a każde twierdzenie musi zweryfikować człowiek, który zna temat i odpowiada za skutki. Zmyślona liczba w tekście o zdrowiu czy podatkach robi czytelnikowi krzywdę, a Google trzyma na tych tematach najwyższą poprzeczkę. Jeżeli nikt nie potrafi sprawdzić poprawności, temat nie nadaje się do automatyzacji.
Ile kosztuje utrzymanie automatyzacji contentu?
Utrzymanie to stała pozycja, nie jednorazowy koszt: pojedynczy workflow w n8n zjada 30–60 minut miesięcznie, a przy złożonych integracjach więcej. Do tego dochodzą opłaty za API modeli rosnące z wolumenem oraz czas na naprawę przepływów, które pękają po zmianie API po drugiej stronie. Największy ukryty koszt to praca człowieka nad wyłapywaniem cichego dryfu, nie same tokeny.
Czy AI zastąpi copywritera?
AI nie zastąpi copywritera, który wnosi doświadczenie, opinię i odpowiedzialność, ale zastąpi tego, który tylko przepisywał konsensus. Model przejmuje zadania powtarzalne, czyli research, szkielet i przeformułowania, a człowiek zostaje przy tym, co niesie information gain. Rynek premiuje dziś copywriterów, którzy sterują automatem, nie tych, którzy konkurują z nim na objętość.
Co to jest thin content i dlaczego automatyzacja go produkuje?
Thin content to treść bez wartości ponad istniejący konsensus, a automatyzacja produkuje go, bo skaluje ilość, nie jakość. Jeden prompt daje sto artykułów, które są przepisaniem pierwszych pozycji Google. Sprawdzisz to testem: usuń zdania, które napisałby konkurent z tego samego promptu, i zobacz, czy cokolwiek zostaje.