Humanizacja tekstu AI – na czym polega i jak ją zrobić w 5 warstwach
Humanizacja tekstu AI to przepisanie tekstu wygenerowanego przez model językowy tak, żeby zniknął z niego statystyczny odcisk modelu – ulubione słowa, składnia, rytm, typografia i układ akapitów – a pojawił się głos i wsad autora. Fakty i sens zostają na miejscu. Znika to, po czym czytelnik już po trzecim zdaniu wie, że pisał ChatGPT albo Claude.
Tekst z modelu jest poprawny i ładnie sformatowany, a mimo to nie podpiszesz go własnym nazwiskiem. Model wybiera słowo najbardziej prawdopodobne, zdanie po zdaniu, więc dostajesz średnią z całego internetu – i czytelnik ją wyczuwa, choć zwykle nie umie powiedzieć, po czym.
Pokażę ci, jak tę średnią wyciąć. Opieram się na własnym badaniu, w którym pięć modeli wygenerowało 236 350 słów na tych samych promptach. Wiem z niego, które nawyki mają wszystkie modele, a które zdradzają jeden konkretny. Listy GPT-izmów nie przepisuję, bo leży w osobnym przewodniku po GPT-izmach.
Najważniejsze wnioski:
- Humanizacja tekstu AI pracuje na pięciu warstwach: słownictwo, składnia, rytm, typografia i struktura. Synonimy ruszają tylko pierwszą.
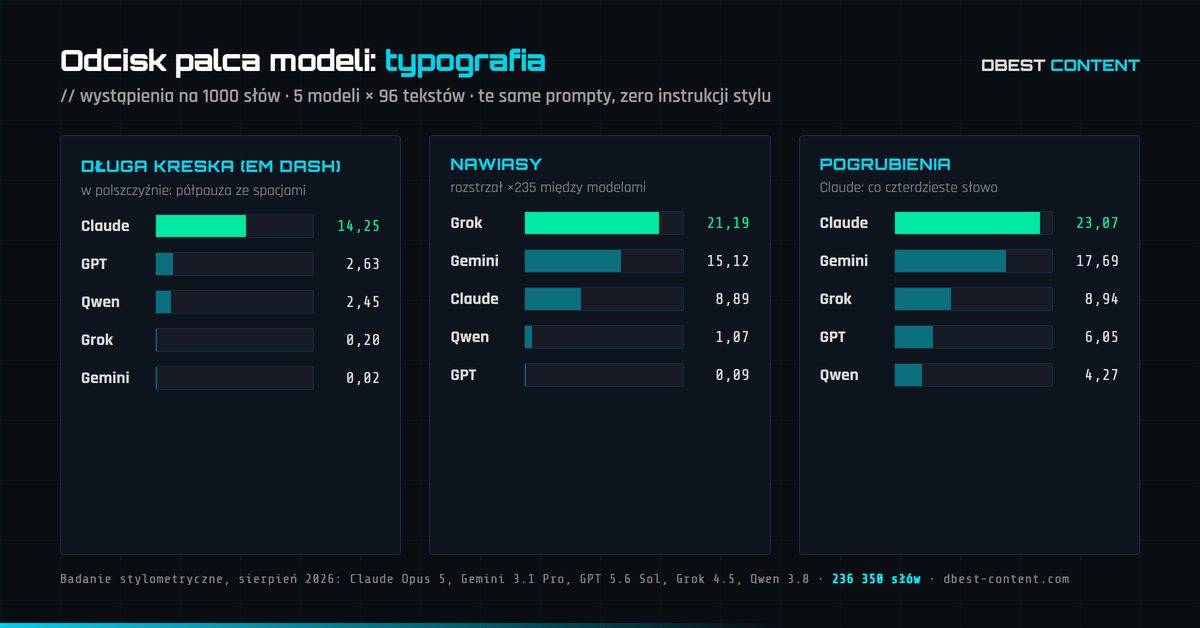
- Każdy model zostawia inny odcisk. Claude stawia długą kreskę 14,25 raza na 1000 słów, Gemini 0,02 raza, a GPT zaczyna zdanie od „Dzięki temu” w co czwartym tekście.
- Rytm wszystkich modeli przypomina metronom: 52–59% zdań ma od 6 do 15 słów, a zdań dłuższych niż 30 słów prawie nie ma.
- Humanizator AI parafrazuje tekst pod detektor, więc składnia i rytm modelu zostają.
- Detektor AI nie zmierzy, czy humanizacja się udała. OpenAI wycofało własny klasyfikator, który wyłapywał 26% tekstów AI.
- Bez wsadu autora wychodzi tekst, który brzmi jak człowiek i niczego nie mówi. Pierwszy etap humanizacji to twoje liczby, przypadki i opinie.
Większość ludzi poprawia tekst w złym miejscu, więc zacznę od tego, co właściwie humanizujesz.
Na czym polega humanizacja tekstu AI
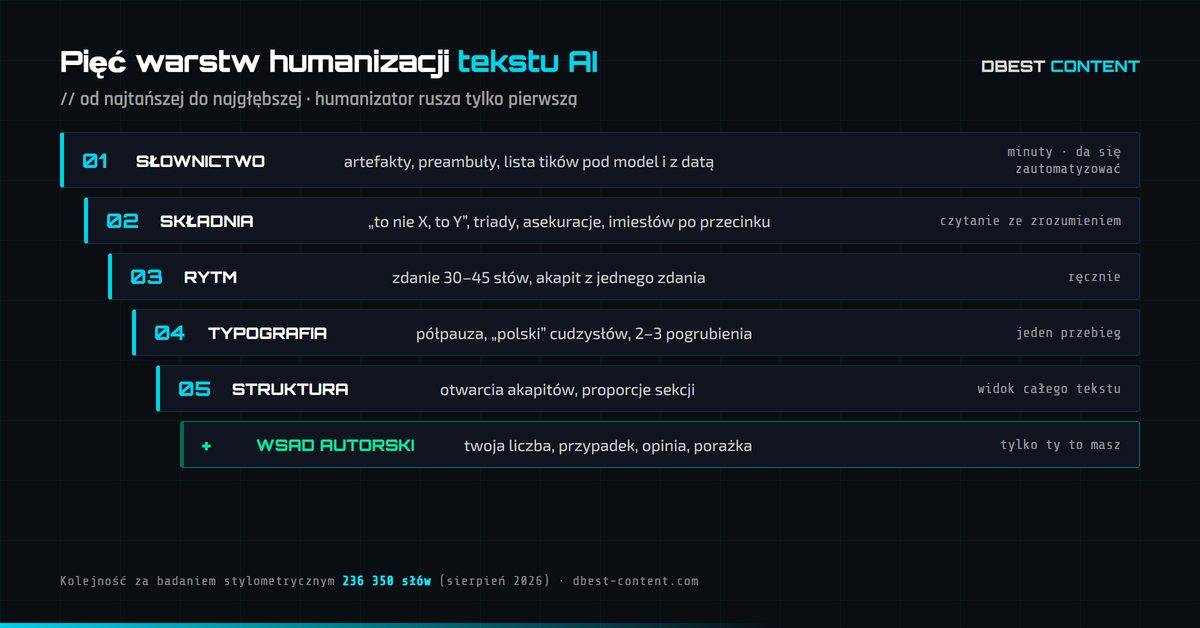
Humanizacja tekstu AI polega na usunięciu wzorców, które model językowy powtarza bez względu na temat, i dołożeniu tego, czego model wiedzieć nie może. Odcisk wycinasz na pięciu poziomach:
- słowa,
- składnia,
- rytm zdań,
- typografia,
- struktura akapitów.
Dokładasz wsad autorski, czyli liczbę z praktyki albo opinię, z którą ktoś mógłby się kłócić.
Skąd w ogóle ten odcisk? Model przewiduje kolejne słowo i bierze to, które w danych treningowych najczęściej stało w podobnym miejscu. Z takich najbezpieczniejszych wyborów, składanych jeden po drugim przez cały tekst, powstaje coś gładkiego i przewidywalnego.
Humanizację da się robić na dwóch płaszczyznach i lepiej rozdzielić je od razu. Pierwsza płaszczyzna to oszukanie detektora AI, druga to tekst, który czytelnik kończy i nie ma poczucia straconego czasu. W filmie z 2025 roku pytałem wprost, czy ktoś tworzy treści po to, żeby oszukać detektor – i ten artykuł gra o tę drugą płaszczyznę.
Humanizacja ma też granice. Faktów nie sprawdza i treści za ciebie nie dopisze. Redakcja merytoryczna, czyli fakty, konkret i logika argumentu, to osobny etap.
Czego humanizacja nie naprawi: tekstu bez treści. Jeżeli po wycięciu wszystkich nawyków modelu zostaje pusty akapit, kłopot leżał na wejściu, w braku materiału.
Jak ten odcisk wygląda w liczbach, policzyłem na pięciu modelach naraz.
Co zdradza tekst z AI – dane z 236 tysięcy słów
W moim badaniu z sierpnia 2026 roku pięć modeli językowych umieściło od 51,8% do 58,8% zdań w paśmie 6–15 słów, a zdania dłuższe niż 30 słów to od 0,2% do 1,6% wszystkich. Tak pisze metronom. Człowiek miesza zdania krótkie, średnie i bardzo długie, model trzyma się środka.
Jak to policzyłem? Wygenerowałem 480 tekstów pięcioma modelami – Claude Opus 5, Gemini 3.1 Pro, GPT 5.6 Sol, Grok 4.5 i Qwen 3.8 – na tych samych 96 promptach, bez instrukcji stylu, za 14,63 dolara. Cały korpus przeszedł potem analizę stylometryczną: częstości słów, konstrukcje, długości zdań i typografię.
Cztery wzorce powtarzają się u wszystkich pięciu modeli:
- Definiowanie przez negację, czyli „to nie X, to Y”, „nie tylko”, „a nie” i „nie chodzi o” – od 16,8 do 27,9 wystąpień na 10 tysięcy słów u każdego modelu.
- Wyliczenia w trójkach typu „szybko, tanio i skutecznie” – od 25 do 74 na 10 tysięcy słów, a u GPT jedno co 135 słów.
- Rytm metronomu z uciętym prawym ogonem: zdań długich prawie brak.
- Akapity od 27 do 38 słów, wszystkie podobnej długości.
Między modelami różnice są za to ogromne. Tak wygląda odcisk palca każdego z nich:
| Model | Najmocniejszy tik słownikowy | Typografia (na 1000 słów) | Typowe otwarcie zdania | Od czego zacząć humanizację |
|---|---|---|---|---|
| Claude Opus 5 | „bez”, „zwykle”, liczby i jednostki („dni”, „zł”) | długa kreska 14,25; pogrubienia 23,07; jedyny model z tabelami | „Zacznij od…” (19% tekstów) | typografia i pogrubienia |
| GPT 5.6 Sol | „oraz”, „warto”, „należy” (1632 na 1 mln słów) | nawiasy 0,09 | „Dzięki temu…” (27% tekstów) | słowa powinności i otwarcia zdań |
| Gemini 3.1 Pro | „idealny”, „kompleksowy”, forma „ty” („twój”, „musisz”) | wykrzykniki 4,34; emoji 3,56 | „Nie musisz…” (15%), „Wyobraź sobie…” (14%) | preambuła asystenta (41% tekstów) i wykrzykniki |
| Grok 4.5 | skróty np. i ok. | nawiasy 21,19; półpauza 27,42 | „Zacznij od…” (24%), „Dlaczego warto…” (23%) | nawiasy i wyciek instrukcji z promptu |
| Qwen 3.8 | „warto” (3714 na 1 mln słów), „jeśli” | nawiasy 1,07 | „Warto też…”, „Jeśli chcesz…” | „warto” i „nie tylko” |
Mało kto wie, że Delta Burrowsa rozpoznaje model w 60,4% przypadków na samych słowach funkcyjnych – spójnikach, przyimkach i partykułach – więc wymiana przymiotników na synonimy nie usuwa odcisku modelu. Na pełnym zestawie słów ta sama metoda przypisała tekst właściwemu modelowi w 69,4% przypadków, przy poziomie losowym 20%. Odcisk siedzi więc także w gramatyce.
Jak humanizować tekst AI krok po kroku
Humanizację tekstu AI robisz od warstwy najtańszej do najgłębszej: artefakty, słownictwo, składnia, rytm, typografia i struktura, a na samym końcu wsad autorski. Dwie pierwsze warstwy zajmują minuty. Kolejne wymagają czytania ze zrozumieniem i to one odróżniają tekst przepuszczony przez humanizator od tekstu przepisanego naprawdę.
- Wytnij artefakty. Usuń preambułę asystenta („Oto propozycja artykułu…”), wyciek instrukcji („Tekst ma ok. 300 słów”), zastrzeżenia, których nie zamawiałeś, i emoji z tekstu dla firm. Gemini dokleja preambułę w 41% tekstów, a Grok zostawia ślady promptu w 51%.
- Wytnij słownictwo tego modelu, z którego korzystasz. Lista ma być ułożona pod konkretny model i mieć datę. Klasyczne „W tym artykule dowiesz się…” pada dziś od 0 do 0,4 raza na 10 tysięcy słów, więc kto wycina je jako główny sygnał, walczy z problemem sprzed dwóch lat. Szukaj rdzeniami, bo „kluczow-” łapie siedem form, a „kluczowy” jedną.
- Rozbij składnię. Zostaw najwyżej jedną negację definiującą na cały tekst, triady skróć do dwóch elementów albo rozbuduj do czterech, a z łańcucha asekuracji („zazwyczaj, w niektórych przypadkach, warto rozważyć”) zostaw jedno zastrzeżenie. Imiesłów doklejony po przecinku („…, co pozwala skupić się na strategii”) zamień na dwa zdania.
- Złam rytm. Dopisz jedno albo dwa zdania długie, na 30–45 słów, z dygresją w środku. Zdanie bardzo krótkie postaw tam, gdzie model by go nie postawił, na przykład w środku akapitu wyjaśniającego. Obok akapitu na osiem zdań daj akapit z jednego.
- Popraw typografię. Długą kreskę zamień na półpauzę ze spacjami, angielskie cudzysłowy na polskie, a z pogrubień zostaw dwa, trzy na cały tekst. Połowę list w stylu „Nagłówek: treść” przepisz na prozę.
- Przeczytaj same otwarcia akapitów, od góry do dołu (dodatkowo, z praktyki). Trzy akapity zaczęte od „Dzięki temu”, „Nie musisz” albo „Zacznij od” przepisz.
- Dołóż wsad autorski (dodatkowo, z praktyki). Wstaw liczbę z własnej praktyki, przypadek, opinię i jedną porażkę – model ich nie wygeneruje, bo ich nie zna.
Rytm: pułapka, w którą wpada połowa „zhumanizowanych” tekstów
Ludzie podmieniają słowa i zostawiają metronom. Druga skrajność jest tak samo zła, bo seria zdań-uderzeń w stylu „Serio. Tyle. To wszystko” to ten sam szablon odwrócony. Uważaj też na parę „krótkie zdanie + długie wyjaśnienie”: Claude produkuje ją 86 razy na 96 tekstów, więc sama w sobie stała się wzorcem. Czasem po krótkim zdaniu powinno iść drugie krótkie.
Słownictwo: lista zakazanych słów ma datę ważności
Lista słów do wycinania starzeje się mniej więcej co rok, bo słownictwo modeli się zmienia. GPT-4 nadużywał „delve” i „crucial”, GPT-4o – „align with” i „enhance”, GPT-5 – „showcasing” i „emphasizing”. Dlatego w moim skillu do humanizacji wzorce strukturalne idą przed listami słów: rytm, bezosobowość i triady przechodzą z wersji na wersję, a ulubione słowa rotują.
Druga pułapka to cięcie na ślepo. Tekst pozbawiony „jeśli”, „sprawdź” i „prosty” brzmi dziwnie, bo ludzie też używają częstych słów. Liczy się gęstość i regularność. Jeżeli „sprawdź” pada w tekście sześć razy, pięć razy powiedz to inaczej.
Przykład przed i po
Przykład ilustracyjny, napisany na potrzeby tego artykułu.
Przed (styl modelu): Automatyzacja e-mail marketingu to nie tylko oszczędność czasu – to kluczowy element strategii. Dzięki temu możesz budować relacje, zwiększać sprzedaż i poprawiać zaangażowanie. Warto więc rozważyć wdrożenie odpowiednich narzędzi.
Po humanizacji: Ustaw jeden mail: przypomnienie o porzuconym koszyku, wysyłane godzinę po tym, jak klient wyszedł ze sklepu. Skonfigurujesz go w jedno popołudnie i potem działa sam. Resztę sekwencji dobudujesz, kiedy zobaczysz, ile koszyków wraca.
W trzech zdaniach wersji „przed” siedzi negacja definiująca, „kluczowy”, otwarcie „Dzięki temu”, triada i „warto rozważyć”. Wersja „po” ma jedną akcję, czas i warunek.
Wszystkie te kroki poprawiają gotowy tekst, a część nawyków da się zatrzymać jeszcze przed generowaniem.
Prompt do humanizacji – co model dostaje na wejściu
Humanizacja zaczyna się przed pierwszym zdaniem modelu: w prompcie systemowym z zasadami stylu, listą zakazanych słów pod konkretny model i 3–5 próbkami tekstu, które oddają głos marki. Taki prompt tłumi nawyki modelu tylko częściowo, więc siedem kroków humanizacji po generowaniu i tak wykonasz. Zmniejsza się za to ilość roboty po generowaniu.
W filmie z 2025 roku porównałem to do dziadka, który od 40 lat jeździ autem po swojemu. Powiesz mu, żeby wcześniej włączał kierunkowskaz, i włączy. Wysiądziesz, a on wróci do starych nawyków, bo jeden prompt nie przebije przyzwyczajeń wyuczonych na terabajtach danych.
Szkielet prompta, od którego możesz zacząć:
Przepisz poniższy tekst po polsku tak, żeby brzmiał jak napisany przez [autor/marka].
Zachowaj wszystkie fakty, liczby i sens. Nie dopisuj nowych informacji.
Styl: zdania od 2 do 40 słów, co najmniej jedno zdanie powyżej 30 słów, akapity różnej długości.
Najwyżej jedna konstrukcja „to nie X, to Y” na cały tekst.
Wyliczenia po dwa albo po cztery elementy.
Typografia: półpauza ze spacjami, cudzysłów „…”, najwyżej trzy pogrubienia.
Zakazane słowa i otwarcia (lista pod model, stan na [data]): [lista].
Próbki stylu autora: [3–5 fragmentów].
Na końcu wypisz zdania, w których nie byłeś pewien, czy zachowałeś sens.
Pustego miejsca na listę nie musisz wypełniać z głowy. W moim korpusie każdy model nadużywał czegoś innego (stan na sierpień 2026), więc zacznij od jego pozycji:
- ChatGPT (GPT 5.6): „oraz”, „warto”, „należy” i otwarcie „Dzięki temu”,
- Claude: długa kreska zamiast półpauzy, pogrubienia, tabele tam, gdzie wystarczy zdanie, i otwarcie „Zacznij od”,
- Gemini: „idealny”, wykrzykniki, emoji, preambuła „Oto…” i otwarcia „Nie musisz” oraz „Wyobraź sobie”,
- Grok: nawiasy, skróty np. i ok. oraz otwarcia „Zacznij od” i „Dlaczego warto”,
- Qwen: „warto”, „nie tylko” i „Jeśli chcesz”.
Do każdej listy dopisz dwa nawyki wspólne dla wszystkich pięciu modeli: definiowanie przez negację i wyliczenia po trzy.
Zasady stylu i listę zakazów trzymaj w stałych instrukcjach projektu, tak jak opisałem w tekście o source of truth. Wtedy nie wklejasz ich od nowa w każdym czacie.
W tym odcinku pokazuję, jak zbudowałem pierwszy, prosty humanizer w Claude i co na to detektor:
Gotowy humanizer z internetu kusi, bo załatwia sprawę w kilka sekund. Tyle że załatwia ją inaczej.
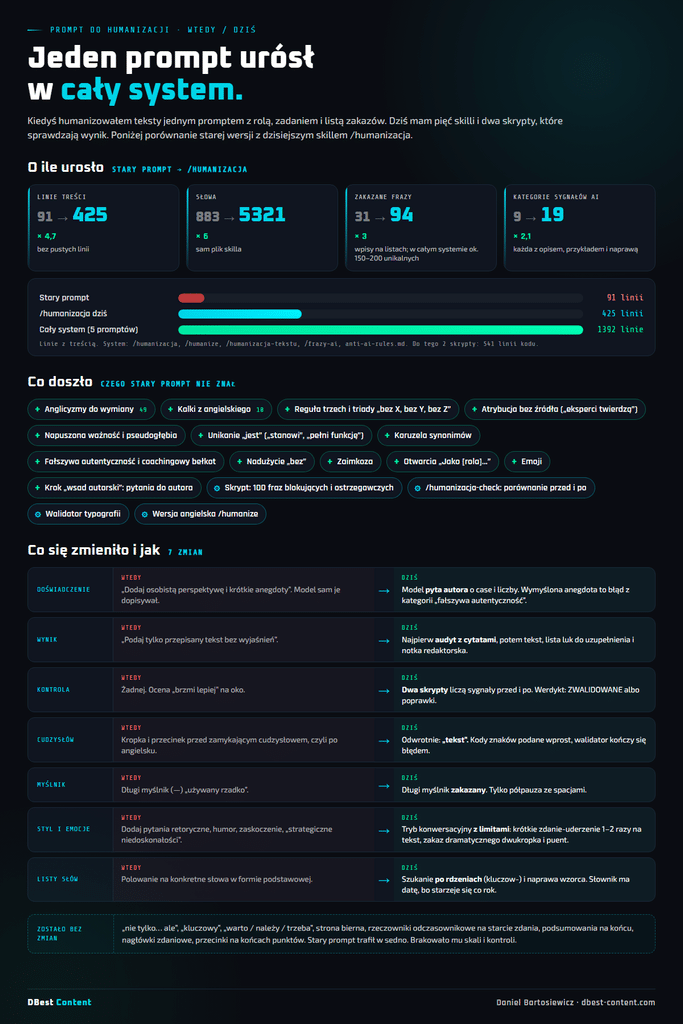
Tak ewoluowały moje prompty do humanizacji.
Humanizator AI czy humanizacja procesem
Humanizator AI zmienia słowa, a proces humanizacji zmienia słowa, składnię, rytm, typografię i strukturę, dlatego tylko proces usuwa odcisk modelu, który czuje czytelnik. Humanizator parafrazuje tekst pod detektor, czyli podmienia słownictwo i przestawia szyk. Wsadu autorskiego nie doda, bo go nie zna.
| Kryterium | Humanizator AI | Humanizacja procesem |
|---|---|---|
| Co zmienia | słownictwo i szyk zdań | słownictwo, składnię, rytm, typografię, strukturę + wsad autora |
| Kto decyduje o zmianie | narzędzie | ty, zdanie po zdaniu |
| Ryzyko dla sensu | wysokie – parafraza potrafi zmienić znaczenie i terminologię | niskie – każdą zmianę robisz świadomie |
| Wsad autora | brak | liczby, przypadki i opinie autora |
| Cel | niższy wynik w detektorze | tekst, który czytelnik kończy i któremu wierzy |
| Polska typografia | zależna od narzędzia, zwykle z angielskimi nawykami | półpauza, polski cudzysłów, interpunkcja |
Ranking konkretnych narzędzi to temat na osobny test, tu chodzi o zasadę. Robiłem taki test przy okazji premiery narzędzia Genuino. Obecnie się w to nie bawię.
Humanizatory sprzedają głównie obietnicę przejścia detektora, więc sprawdźmy, ile ona jest warta.
Okiem autora
Daniel Bartosiewicz · automatyzacja contentu z AI
Aktualnie uważam tak – tekst albo ssie, albo nie. Nieważne, czy pochodzi z AI, czy pisał go człowiek. Widziałem dostatecznie dużo human slopu, żeby nie sarkać na AI slop. Bo gdyby teksty od człowieka z definicji były lepsze, to wszystkie teksty przed 2022 rokiem byłyby dobre.
A były?
Nie, i to jest odpowiedź.
Tekst albo robi robotę, albo nie robi. Albo konwertuje, albo nie.
I prawda jest taka, że jeśli firma miałaby do wyboru:
1. Tekst z AI, który sprzedaje jak głupi,
2.Tekst od człowieka, który nie sprzeda nawet wody na pustyni.
Wybierze to pierwsze.
Humanizacja a detektory AI i Google
Detektor AI nie mierzy jakości humanizacji, bo szacuje przewidywalność tekstu i myli się w obie strony. OpenAI wycofało własny klasyfikator tekstów AI 20 lipca 2023 roku, bo wykrywał tylko 26% tekstów napisanych przez AI i w 9% przypadków oznaczał tekst człowieka jako maszynowy. Według badania Liang i współpracowników z 2023 roku detektory GPT uznały za AI średnio 61,22% esejów TOEFL, które napisali ludzie, dla których angielski jest drugim językiem.
Sam sprawdzałem to w 2025 roku. Prosty humanizer w Claude obniżył wynik polskiego detektora semantyk.pl z 83% do 25% AI na artykule, a na poście z LinkedIna z 45% do 15%, a mimo to Copyleaks rozpoznał tekst jako maszynowy. Detektory patrzą głównie na przewidywalność i zmienność zdań, więc nagradzają złamany rytm, a pozostałych warstw nie widzą.
Google trzyma się stanowiska z 8 lutego 2023 roku: właściwe użycie AI nie narusza wytycznych, a spamem jest automatyczne generowanie treści głównie po to, żeby manipulować rankingiem. W FAQ do tego wpisu Google na pytanie o treści z AI odpowiada jednym zdaniem: „Appropriate use of AI or automation is not against our guidelines”. Wyszukiwarkę obchodzi tekst, narzędzie mniej.
Umówmy się: tekst albo robi robotę u czytelnika, albo jej nie robi, i żaden procent w detektorze tego nie zmieni. Do sprawdzania humanizacji potrzebujesz więc czegoś innego.
Jak sprawdzić, czy humanizacja zadziałała
Humanizację sprawdzasz, porównując wersję przed i po liczbami: podobieństwo tekstów, odsetek zdań nietkniętych, zmienność długości zdań i nowe liczby, których w oryginale nie było. Model, który przed chwilą przepisał tekst, jest najgorszym sędzią własnej roboty. Widzi swoje zmiany i z góry uznaje je za skuteczne.
Mój walidator humanizacji ma cztery progi:
- podobieństwo wersji przed i po na poziomie 0,92 lub wyżej znaczy, że humanizacji nie było, tylko podmiana kilku słów,
- 50% lub więcej zdań przepisanych bajt w bajt znaczy to samo,
- zmienność długości zdań poniżej 0,25 znaczy, że rytm dalej chodzi jak metronom,
- różnica długości większa niż 35% znaczy, że model dopisał treść albo ją wyciął.
Do tego pięć pytań, na które odpowiadasz sam przed publikacją:
- Czy liczby, nazwy i daty z oryginału przetrwały?
- Czy po pierwszym akapicie wiadomo, kto pisze?
- Czy jest tu choć jedna rzecz, której model by nie wygenerował?
- Czy synonim naprawił zdanie, czy tylko obszedł listę zakazów?
- Czy przeczytasz tekst na głos i się nie potkniesz?
U mnie humanizacja to osobny, obowiązkowy krok z walidacją, a poprawki „na oko” odpadły. Skąd ta decyzja, opisałem przy tekście o tym, jak dzielić pracę między AI a człowieka w copywritingu.
Zostaje pytanie, od czego zacząć w twojej sytuacji.
Od czego zacząć humanizację – macierz decyzji
Jeżeli tekst idzie pod twoim nazwiskiem albo marką, humanizuj procesem, a humanizator zostaw do tekstów, których nikt nie podpisuje. Jeżeli piszesz głównie w Claude, zacznij od typografii: długich kresek, pogrubień i tabel. Jeżeli w ChatGPT, zacznij od słów powinności („należy”, „warto”) i otwarć „Dzięki temu”. Jeżeli w Gemini, wytnij preambułę asystenta i otwarcia „Nie musisz” oraz „Wyobraź sobie”.
Masz 15 minut? Zrób artefakty, typografię i przegląd otwarć akapitów. Jeżeli piszesz serię tekstów, wpisz zasady stylu i listę zakazów do promptu systemowego, a pierwszy tekst z serii puść przez walidację przed i po. Jeżeli zmieniasz model albo od ostatniej listy minęło pół roku, zmierz nawyki modelu od nowa, bo stara lista łapie słowa, których nowy model już nie używa.
Jeżeli po wycięciu nawyków w tekście nie zostaje nic od ciebie, wróć do wsadu. Doświadczenia, którego nie podałeś, humanizacja nie dopisze.
Chcesz przejść ten proces na własnych tekstach, od profilu twojego głosu przez humanizację po ocenę gotowego tekstu? Zrobiłem z tego mini-kurs Slopkiller. Kosztuje 97 zł, a w środku dostajesz narzędzia, z których sam korzystam przy każdym tekście.
Humanizacja tekstu AI – najczęstsze pytania
Czy humanizator AI wystarczy, żeby tekst brzmiał jak napisany przez człowieka?
Nie, humanizator AI zmienia głównie słownictwo i szyk zdań. Odcisk modelu siedzi też w słowach funkcyjnych, rytmie i strukturze: metoda Delta rozpoznaje model w 60,4% przypadków na samych spójnikach, przyimkach i partykułach. Twoich liczb i przypadków humanizator też nie doda, bo ich nie zna.
Czy humanizacja tekstu AI pomaga przejść detektor AI?
Humanizacja zwykle obniża wynik detektora, ale przejścia nie gwarantuje. W teście z 2025 roku wynik w semantyk.pl spadł z 83% do 25% AI, a Copyleaks i tak rozpoznał tekst. Detektory mylą się w obie strony, dlatego nie traktuj ich jako miary jakości.
Ile kosztuje humanizacja tekstu AI?
Humanizacja tekstu AI kosztuje głównie czas, bo darmowe humanizatory mają limity na jeden tekst. W październiku 2026 roku DiagnoSEO przyjmował za darmo do 5000 znaków, Monica 250 słów, a StudyTexter 500 słów miesięcznie po rejestracji. Artykuł na 1500 słów ma około 10 tysięcy znaków i nie mieści się w żadnym z tych limitów. Humanizacja procesem nie wymaga abonamentu, a ile trwa u mnie, piszę przy tabeli porównawczej.
Czy Google obniża pozycje tekstom z AI, które nie przeszły humanizacji?
Google nie obniża pozycji za samo użycie AI – według stanowiska z 8 lutego 2023 roku właściwe użycie AI nie narusza wytycznych. Karze treści generowane głównie po to, żeby manipulować rankingiem. Tekst bez humanizacji przegrywa zwykle dlatego, że jest przeciętny i nie wnosi nic nowego.
Czy humanizacja tekstu AI zmienia sens tekstu?
Humanizacja tekstu AI nie może zmieniać sensu: fakty, liczby, nazwy i daty zostają, zmienia się sposób ich podania. Ryzyko rośnie przy automatycznej parafrazie, która potrafi podmienić termin fachowy na synonim o innym znaczeniu. Po humanizacji porównaj więc obie wersje, a różnicę długości większą niż 35% traktuj jako sygnał, że model coś wyciął albo dopisał.
Czy prompt systemowy zastąpi humanizację tekstu AI?
Prompt systemowy humanizacji nie zastąpi, za to ją skróci. Instrukcje stylu tłumią nawyki modelu częściowo i część zakazanych słów oraz konstrukcji i tak przecieka do tekstu. Po każdym tekście sprawdź, co przeszło mimo zakazu, i dopisz to do listy.
Czy humanizacja usuwa watermark z tekstów Claude’a?
Zwykła humanizacja nie gwarantuje usunięcia watermarku, bo Anthropic od 2 sierpnia 2026 roku zaszywa znacznik w doborze słów, a nie w metadanych. Jak działa ten mechanizm i co go usuwa, opisałem w tekście o watermarkach w tekstach Claude’a.
Czy humanizacja tekstu AI po polsku różni się od humanizacji po angielsku?
Tak, humanizacja tekstu AI po polsku ma dwie dodatkowe warstwy: typografię i fleksję. Polski tekst wymaga półpauzy ze spacjami, cudzysłowu „…” i kropki za cudzysłowem, a modele przenoszą do niego angielskie nawyki. Listy zakazanych słów przeszukujesz rdzeniami, bo jedno słowo ma po polsku nawet siedem form.