Jak sprawić, żeby tekst z AI nie brzmiał jak AI już przy pisaniu
Żeby tekst z AI nie brzmiał jak AI, model musi dostać przed pisaniem cztery rzeczy: cel i odbiorcę, twoje fakty, 3–5 próbek twojego głosu i reguły, które mówią, co ma robić. Potem pisze sekcjami, według planu. Humanizacja treści przychodzi na sam koniec i zajmuje chwilę, bo najcięższą robotę odwalił wsad.
Większość ludzi zaczyna od złej strony. Wpisują „napisz artykuł o X”, dostają poprawną papkę i wrzucają ją do narzędzia, które obiecuje ją uczłowieczyć.
Albo dłubią w niej słowo po słowie. Tak tego nie wygrasz, bo poprawiasz skutek, podczas gdy przyczyna siedzi w tym, co model dostał na wejściu.
Sprawdziłem to na 9 fragmentach z jednego modelu, przy trzech wariantach prompta. W dwóch miejscach wynik mnie zaskoczył – pokażę ci oba w liczbach.
Najważniejsze wnioski:
- Sztuczność bierze się głównie z tego, czego model nie dostał: bez faktów, celu i próbek głosu wypełnia luki średnią z danych treningowych.
- Sama lista zakazów wycina pogrubienia i listy, ale w moim teście w 3 z 3 próbach model dopisał zmyśloną scenkę z klientką, miastem albo cytatem.
- Pełny wsad dał 0 zmyśleń na 3 próby, a krótkich zdań było 28,6% zamiast 5,6% przy gołym prompcie.
- Styl prompta przechodzi na wynik: w moim teście negacja zapisana w tezie wróciła we wszystkich trzech próbach jako tik składniowy.
- Wsad załatwia treść i formę, tiki składniowe modelu zostają, więc humanizacja domyka robotę na końcu.
- Detektor AI nie powie ci, czy treść jest dobra, bo ocenia podobieństwo do typowego wyniku modelu.
Zacznijmy od źródła tej sztuczności.
Dlaczego tekst generowany przez AI brzmi sztucznie
Tekst z AI brzmi sztucznie, bo model językowy wypełnia każdą lukę we wsadzie najbardziej prawdopodobnym słowem, a suma takich wyborów daje przewidywalną średnią z danych treningowych. Treści generowane bez wsadu różnią się tematem, a tekst brzmi tak samo u każdego, kto dał modelowi tylko temat.
Co pominiesz, model dopowie wzorcem. Albo zmyśli.
Dlatego we wpisach zupełnie różnych osób wracają te same sformułowania i ten sam rytm zdań, a nawet akapity mają podobną długość. Każdy z tych autorów dał modelowi prawie nic i każdy dostał identyczną średnią.
Jak ją rozpoznać, rozpisałem w osobnym przewodniku po GPT-izmach. Tutaj interesuje mnie, jak jej w ogóle nie dostać.
W czerwcu nagrałem film o AI slopie i postawiłem w nim tezę, że o jakości wpisu decydujesz przed pierwszym promptem. Potem już tylko tym, ile czasu mu oddasz. Działa tu stara zasada z ringu: im więcej potu na treningu, tym mniej krwi na ringu – robotę pominiętą na wejściu i tak odrobisz na wyjściu, w poprawkach.
Ile z tego da się załatwić samym promptem? Zmierzyłem to.
Test: goły prompt, lista zakazów i pełny wsad
8 listopada 2026 roku wygenerowałem w Claude Sonnet 5.5 dziewięć fragmentów artykułu, po trzy na każdy wariant prompta, a skrypt analizował każdy z nich na wzorcach z mojego walidatora humanizacji. Temat był wspólny: dlaczego małe biuro rachunkowe ma odpowiadać na opinie w Google, około 350 słów. Model nie znał moich instrukcji ani pamięci, każda generacja szła w świeżej sesji.
Trzy warianty wyglądały tak:
- goły prompt – jedno zdanie z tematem i długością,
- lista zakazów – to samo zdanie plus „Nie pisz jak AI”, siedem zakazanych słów i zakaz długich myślników, pogrubień i list,
- pełny wsad – odbiorczyni i jej obiekcja, cel po lekturze, jedna teza, sześć faktów do użycia (fikcyjnych, przygotowanych na test), trzy próbki głosu i reguły zapisane prozą: zacznij od wniosku, mów na „ty”, mieszaj zdania krótkie z długimi.
| Wskaźnik (średnio na próbę) | Goły prompt | Lista zakazów | Pełny wsad |
|---|---|---|---|
| Pogrubienia | 4,7 | 0 | 0 |
| Punkty list | 4 | 0 | 0 |
Dopiski czatu („Mogę go skrócić…”) albo separator --- | 2 z 3 prób | 0 z 3 | 1 z 3 |
| Zmyślone szczegóły bez źródła | 3 z 3 | 3 z 3 | 0 z 3 |
| Zdania do 5 słów | 5,6% | 16,1% | 28,6% |
| Zmienność długości zdań (im wyżej, tym mniej metronomu) | 0,39 | 0,52 | 0,66 |
| Otwarcie z negacją „Nie dlatego…, tylko dlatego…” | 0 z 3 | 0 z 3 | 3 z 3 |
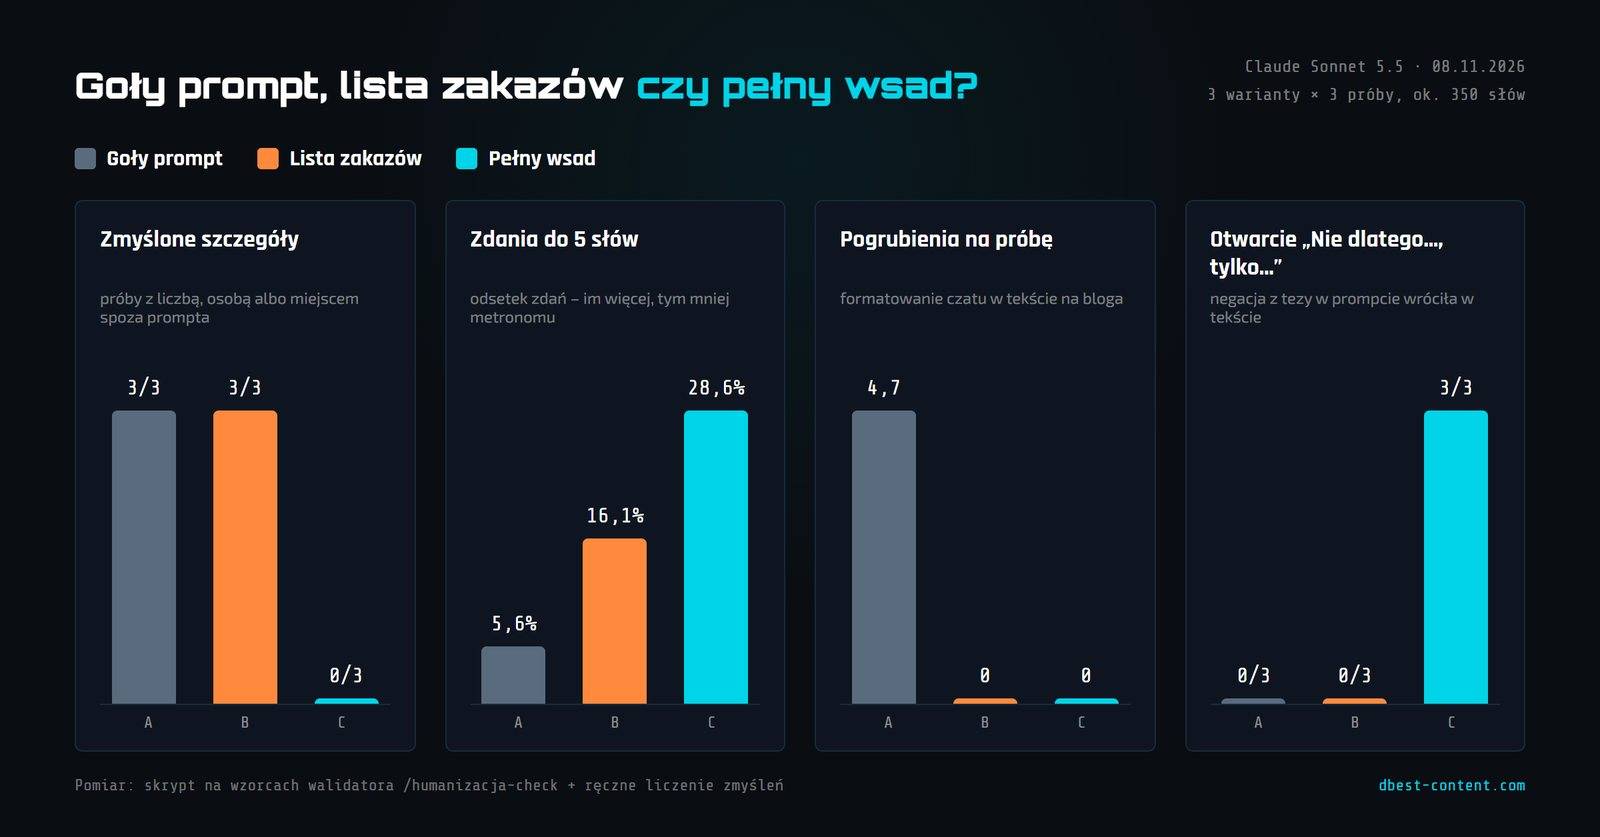
Z gołego prompta wyszło to, czego się spodziewasz. Nagłówek, pogrubione śródtytuły, lista „jak to robić”, a na końcu dopisek asystenta, że może wynik skrócić. Plus rady z liczbami wziętymi z sufitu, typu „odpowiadajcie w ciągu 48 godzin”.
Lista zakazów wycięła całe to formatowanie. Tyle że w zamian model nie dostał nic.
Mało kto wie, że sama lista zakazów popycha model w zmyślenia: w teście z 8 listopada 2026 roku Claude Sonnet 5.5 z zakazami dopisał wymyśloną scenkę w 3 z 3 prób, a z pełnym wsadem w 0 z 3. Dwa razy wyskoczyła „Pani Ewa”: raz jako właścicielka biura, raz jako klientka szukająca księgowej w Gliwicach, gdzie konkurencja miała ocenę 4,8 – w prompcie nie było żadnej z tych rzeczy. Zakaz ogólników zmusił model do konkretu, a ponieważ materiału nie miał, konkret wymyślił.
Pełny wsad trafił w rytm i trzymał się faktów. Wszystkie trzy próby otworzyły się jednak niemal identycznie: „Opinia bez odpowiedzi pracuje dla konkurencji. Nie dlatego, że jest zła…” – a dalej padało, że jest cicha albo wisi sama.
Skąd to? Z mojego prompta.
Tezę zapisałem z negacją („czytelnik widzi milczenie, a nie samą ocenę”), a model rozdmuchał ją do klasycznego tiku. Doszły wyliczanki w rodzaju „nie kampanii, nie reklamy, nie rabatu” i słowo „bez” średnio pięć razy na próbę.
Ograniczenia testu: pełny wsad zmienia naraz trzy rzeczy (fakty, próbki i reguły), więc nie wiem, ile dała każda z osobna. Trzy próby na wariant, jeden model, jeden temat – traktuj to jako kierunek. Prompty, wszystkie 9 wyników i skrypt do pomiaru trzymam w folderze testu – napisz, jeżeli chcesz je dostać i powtórzyć test na swoim modelu.
Ile to kosztuje czasu? Firmowy kontekst budujesz raz: kim jesteś, dla kogo piszesz, jak brzmisz i czego model ma nie używać. U mnie to 2–3 godziny jednorazowo. Potem wsad do pojedynczego artykułu zajmuje mi 15–30 minut, a cała robota przy tekście skraca się mniej więcej o połowę.
Nie mierzyłem tego stoperem. To prywatna obserwacja z mojego biurka, więc sprawdź ją na własnych tekstach.
Najwięcej czasu i tak zjada mi redakcja na serio, czyli czytanie gotowego tekstu zdanie po zdaniu.
Z tych liczb układa się konkretna kolejność działania.
Jak sprawić, żeby AI nie brzmiało jak AI – 7 decyzji przed pierwszym promptem
Żeby AI nie brzmiało jak AI, przejdź przez siedem decyzji po kolei: czy model w ogóle ma pisać, jaki efekt ma dać, jakie fakty dostanie, jakim głosem ma mówić, który model i z jaką listą zakazów, jak zapiszesz prompt i w jakich porcjach model ma pracować. Pięć pierwszych załatwiasz jeszcze poza czatem. Dwie ostatnie dzieją się już w nim.
1. Zdecyduj, czy AI w ogóle ma pisać ten tekst
Część treści zdradza model, bo w ogóle nie powinna z niego wychodzić. Copy sprzedażowe dla klienta indywidualnego, oparte na emocjach, albo felieton z twoją opinią szybciej napiszesz sam, niż wyciśniesz je z modelu i potem przepiszesz. Poradnik czy opis produktu to co innego – tu model spokojnie pisze szkic, a ty dokładasz wsad.
2. Opisz efekt końcowy: cel, odbiorcę i jedną tezę
Nie prowadź modelu za rękę krok po kroku. W filmie ująłem to tak: ty mówisz, co chcesz dostać na końcu, a model ma to sobie wykoncypować. Napisz, kto czyta, jaką ma obiekcję i co ma zrobić po lekturze.
Tezę zapisz twierdząco. Konstrukcja „X, a nie Y” z briefu wróciła w moim teście jako tik z negacją w pierwszym zdaniu każdej próby.
Zamiast „czytelnik widzi milczenie, a nie samą ocenę” daj modelowi „czytelnik ocenia biuro po tym, czy właścicielka odpisuje”. Pełną listę pól briefu dla modelu rozpisałem w osobnym artykule o planie i briefie.
3. Daj fakty, których model nie zna
Liczby z twojej firmy, przypadki klientów, ceny z datą, cytaty, wyniki testów. Model tego nie ma, więc tekst wygenerowany bez takich danych stoi na zgadywaniu, a model zgaduje płynnie i z pełnym przekonaniem – w teście wyszła z tego klientka z Gliwic.
Fakt z twojego podwórka zabija ogólnik. Do tego daje czytelnikowi coś, czego nie znajdzie w dziesięciu innych artykułach na ten temat – w SEO nazywa się to information gain. Wpis z liczbą, którą da się sprawdzić, jest po prostu wiarygodny.
Faktów brak? Wstrzymaj się z generowaniem. Zbierz je albo każ modelowi zadać ci pytania (o tym w kroku 7).
Okiem autora
Daniel Bartosiewicz · automatyzacja contentu z AI
Po tych 20–30 minutach, w których dokładam do tekstu coś od siebie, mam poczucie, że tekst jest mój. Brzmi bardziej jak ja niż wcześniej. Mam z nim kontakt i wiem, co w nim stoi, więc spokojnie się pod nim podpisuję.
4. Pokaż swój głos: próbki i profil stylu
Dopóki nie pokażesz modelowi, jak brzmisz, będzie zgadywał. Daj mu 3–5 swoich próbek z jednego rejestru, za to o różnych tematach – tyle zaleca Anthropic w dokumentacji Claude’a.
Więcej nie znaczy lepiej. W badaniu na ponad 400 autorach zwiększenie liczby przykładów z 2 do 10 dawało bardzo niewielki zysk, a najsłabiej modele radziły sobie z luźnym stylem blogów i forów.
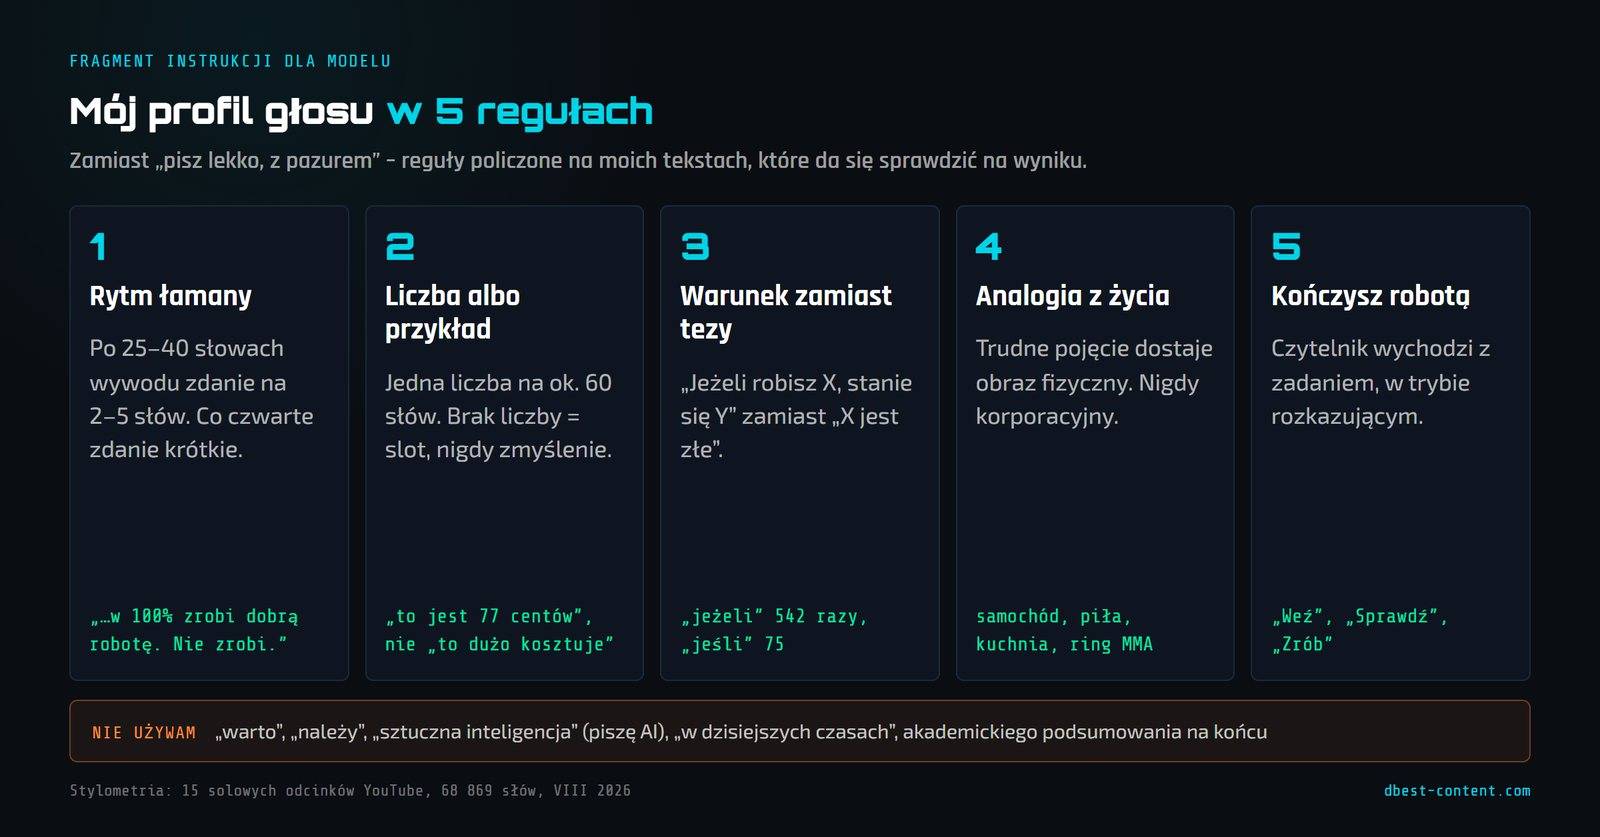
„Lekko, z pazurem, profesjonalnie” – takie przymiotniki nic modelowi nie mówią. Dużo lepiej działa profil głosu policzony na twoich tekstach: długość zdań, sposób, w jaki je zaczynasz, słowa, których nie używasz wcale.
Taki styl pisania zapiszesz jako reguły z liczbami. Model je wykona, ty sprawdzisz je na wyniku.
Dorzuć jeden zły przykład i dwa zdania komentarza, co w nim nie gra. Uważaj tylko na jedną rzecz, o której mówiłem w filmie: jeżeli dasz modelowi swój najlepszy post jako wzór, każdy kolejny zacznie wyglądać jak jego kopia.
Tak wygląda fragment mojego profilu, który model dostaje w instrukcjach. Policzyłem go stylometrią na 15 moich solowych odcinkach na YouTubie, prawie 69 tys. słów.
Protip
Paradoksalnie największą zmianę w moich tekstach dały wartości. Reguły i listy zakazanych czy pożądanych słów pomagały mniej niż kilka zdań o tym, kim jestem i w co wierzę. Nie znoszę marnotrawstwa, ściemniaczy i politycznej poprawności. Lubię sarkazm i czasem komuś dogryźć, rzadko gryzę się w język. Ten akapit wklejam na sam koniec prompta do humanizacji, bo model najlepiej wykorzystuje to, co stoi na początku i na końcu instrukcji, a ze środka długiego kontekstu gubi najwięcej.
5. Wybierz model i dopasuj do niego listę zakazanych słów
Każdy model ma swoje ulubione słowa i konstrukcje, więc lista zakazów działa pod jeden model i ma datę ważności. Spisana pod ChatGPT nie złapie nawyków Claude’a.
Spisana rok temu łapie słowa, po które nowy model już nie sięga. Ulubione słowa poszczególnych modeli rozkładam na części w filmie o ulubionych słowach LLM-ów.
Samej liście nie ufaj. Weź kogoś, kto zna ograniczony zasób słów, i daj mu spis zakazanych. Co wstawi w puste miejsca?
Inne słowa z tego samego, ubogiego zestawu. Model zachowa się identycznie – „kluczowy” zamieni na „istotny”, a szablon zdania zostawi w spokoju. Lista zakazów dokłada się więc do faktów i próbek, ale żadnego z nich nie zastąpi.
6. Napisz prompt tym stylem, którego oczekujesz w wyniku
Opisuj, co model ma robić. Anthropic radzi zamienić „nie używaj Markdownu” na prośbę o płynne akapity prozy i dodaje, że styl prompta wpływa na styl odpowiedzi. Mój test potwierdził tę zasadę od strony składni: negacja z tezy wylądowała w gotowym fragmencie.
Do każdej reguły dopisz powód. „Zaczynaj od wniosku, bo czytelniczka ma mało czasu i czyta pierwsze zdanie” zadziała lepiej niż sama reguła, bo model rozciągnie powód na sytuacje, których nie przewidziałeś. Budowę polecenia rozbieram w artykule o tym, jak pisać prompty do AI.
7. Twórz od planu, sekcja po sekcji, i każ modelowi pytać
Najpierw plan, potem szkic, sekcja po sekcji. Każda sekcja dostaje własny cel i własne fakty. Model nie rozlewa wtedy jednej myśli na cały artykuł i nie ciągnie jednego rytmu przez 2000 słów.
Nie wiesz, co dać modelowi? Odwróć role i napisz: „Chcę, żeby ten mail otworzyła połowa odbiorców. Najpierw zadaj mi pytania o ten mail, potem napisz go”. Pięć odpowiedzi później masz wsad, którego sam byś nie spisał.
A jeżeli ten sam błąd wraca w trzecim wpisie z rzędu, popraw prompt zamiast kolejnego wpisu.
Brzmi jak dużo roboty? Bo jest. Profil głosu, lista zakazów pod twój model, próbki, prompt i walidacja to kilka wieczorów pracy, a dopiero potem system działa sam. Dlatego zrobiłem z tego mini-kurs SlopKiller. Przestań poprawiać teksty po AI za 97 zł. W środku jest 9 lekcji wideo: Wstęp, Ważne kwestie techniczne, Naucz AI mówić Twoim głosem, Usuń cechy AI z tekstu, Audyt tekstu, Wyróżnik marki, Audyt konkurencji i dwa bonusy – Formaty treści oraz Odwróć wektor. Dostajesz gotowe skille do Claude’a: humanizacja, humanizacja-check, stylometria (profil twojego głosu), ai-audit, fact-checker, wyroznik-marki, audyt-konkurencji, audyt-seo, audyt-perswazji i porownanie-z-konkurentem, plus wtyczkę do Chrome do zbierania treści z LinkedIna. Do tego e-book PDF o cechach modeli z eksperymentu na 500 tekstach (236 tys. słów, 5 modeli) i prompty pod konkretny model. Zobacz, co jest w SlopKillerze.
Cała droga od decyzji do gotowego artykułu na jednym schemacie:
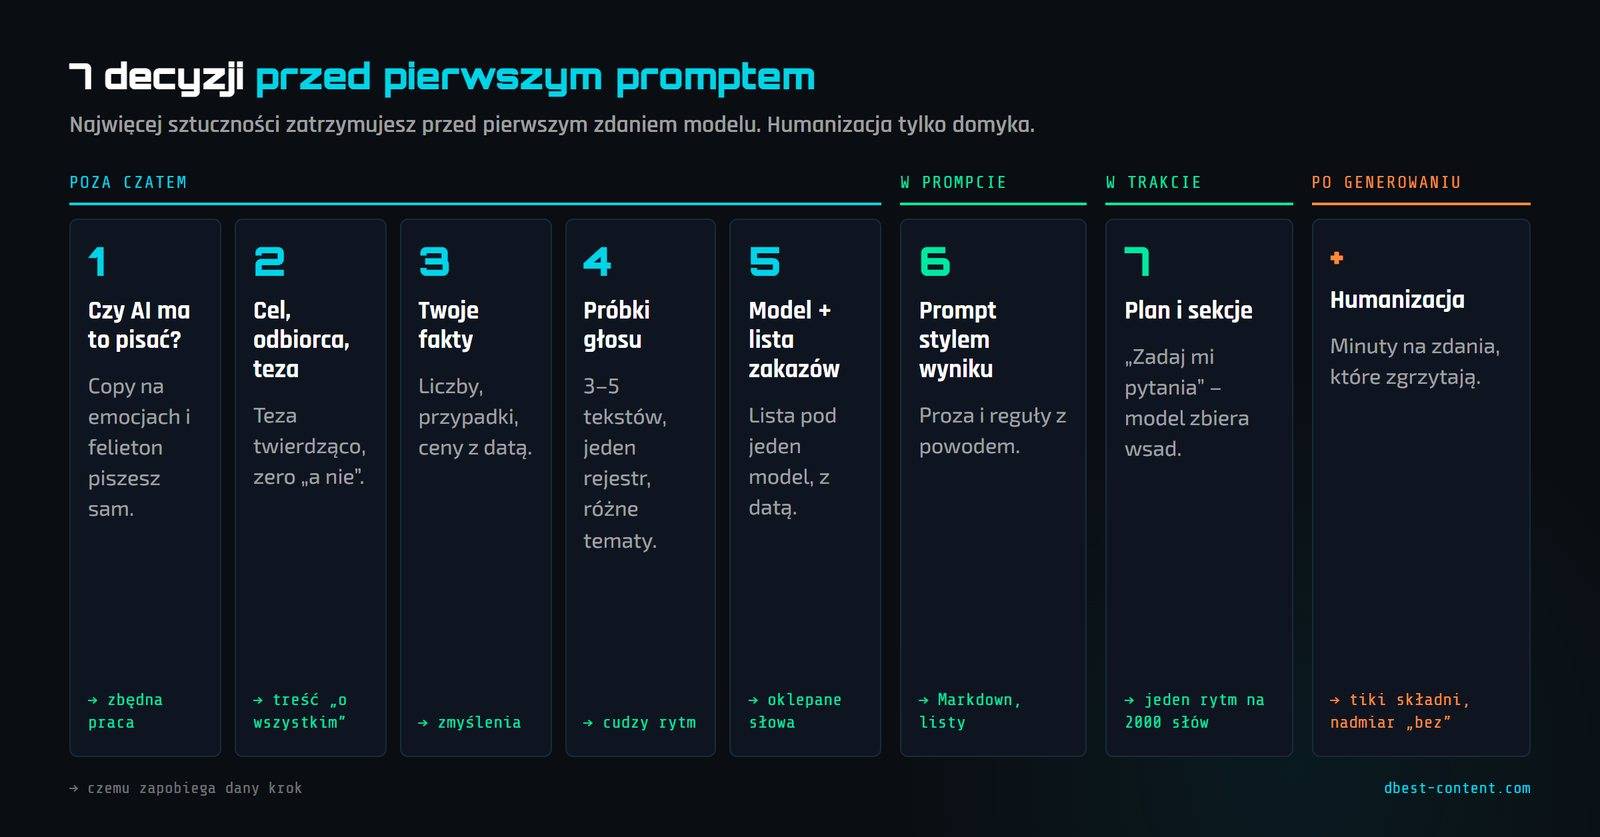
| Co dajesz modelowi | Czemu zapobiega | Czego nie załatwi |
|---|---|---|
| Cel, odbiorca, jedna teza | rozlanej treści „o wszystkim” | stylowi – model dalej pisze swoim głosem |
| Fakty własne | zmyślonym liczbom, scenkom i ogólnikom | składni modelu |
| 3–5 próbek głosu | rytmowi metronomu i obcemu słownictwu | faktom – próbki ich nie dostarczą |
| Lista zakazów pod model | najbardziej oklepanym słowom i otwarciom | zamiennikom z tego samego szablonu |
| Prompt prozą z regułami pozytywnymi | Markdownowi, pogrubieniom i listom w wyniku | negacjom, które sam wpiszesz do prompta |
| Pisanie sekcjami według planu | powtórzeniom i jednemu rytmowi na 2000 słów | tikom składniowym modelu |
Nawet z kompletem tej tabeli coś przecieknie. Pora na ostatnią warstwę.
Humanizacja i detektory AI – ostatnia warstwa procesu
Wsad zapobiega zmyśleniom, formatowaniu czatu i rytmowi metronomu, ale tików składniowych modelu nie usuwa, dlatego humanizacja zostaje ostatnią warstwą. W moim teście nawet najlepszy wariant zostawił otwarcie z negacją, wyliczanki z „nie” i za dużo „bez”. Takie rzeczy widać dopiero przy czytaniu gotowego wpisu.
Po dobrym wsadzie humanizacja trwa minuty, godzina odpada. Humanizujesz pojedyncze zdania, zamiast przepisywać cały artykuł od zera.
Pięć warstw tej roboty, od słownictwa po strukturę, rozpisałem w artykule o tym, co robić, gdy tekst z AI brzmi sztucznie i chcesz go zmienić na ludzki. Prosty humanizer na promptach zbudowałem też w tym odcinku.
Humanizator to inna para kaloszy. To narzędzie parafrazuje treść tak, żeby obniżyć wynik wykrywania AI – podmienia słowa, przestawia szyk. Twoich faktów ani głosu nie doda, bo skąd miałby je znać?
Detektor AI też nie mierzy sukcesu. To narzędzie wykrywa przewidywalność, jakość go nie obchodzi. W badaniu z 2025 roku GPTZero rozpoznawał jako maszynowe większość prób pisanych z próbkami stylu autora, choć modele dostały wzory do naśladowania.
Copyleaks, Originality.ai czy uczelniany Turnitin też szacują prawdopodobieństwo, że tekst wyszedł z modelu – o jego wartości nie mówią nic. Umówmy się: wolisz copy, które detektor uzna w 100% za AI, a które sprzedaje, czy copy z wynikiem 0% AI, które nie sprzedaje niczego? Ja biorę pierwsze.
Zostaje pytanie, od czego zacząć u siebie.
Od czego zacząć – macierz decyzji
Jeżeli potrzebujesz jednego wpisu na szybko, daj modelowi cel, odbiorcę, trzy fakty i prompt pisany prozą, a pozostałe kroki odpuść. Jeżeli robisz serię wpisów tego samego typu, zbuduj profil głosu i zapisz go razem z listą zakazów w stałych instrukcjach projektu – nie będziesz wklejać wszystkiego od nowa w każdym czacie.
Jeżeli nie masz żadnych faktów, wstrzymaj generowanie, aż je zbierzesz, albo każ modelowi zadać ci pytania. Jeżeli to copy sprzedażowe oparte na emocjach, napisz je sam, a model dostaje je najwyżej do korekty.
Jeżeli zmieniasz model, spisz listę zakazów od nowa, bo stara łapie nawyki poprzednika. Jeżeli po pełnym wsadzie wynik dalej trąci AI, nie dokładaj kolejnego prompta.
Przeczytaj go na głos i przepuść przez humanizację zdania, które zgrzytają. A jeżeli chcesz przejść całą tę drogę z gotowymi narzędziami, masz ją w SlopKillerze.
Jak sprawić, żeby tekst z AI nie brzmiał jak AI – najczęstsze pytania
Czy dopisek „nie pisz jak AI” w prompcie do ChatGPT usunie styl AI?
Nie, taki dopisek usuwa najwyżej formatowanie. W moim teście z 8 listopada 2026 roku lista zakazów wycięła pogrubienia i listy, ale w 3 z 3 prób model dopisał zmyśloną scenkę. Zakaz nie daje modelowi treści, więc ten ją sobie wymyśla.
Ile próbek tekstu potrzebuje Claude, żeby pisać twoim stylem?
Claude potrzebuje 3–5 próbek z jednego rejestru – tyle zaleca Anthropic. Badanie z 2025 roku na ponad 400 autorach pokazało, że przejście z 2 do 10 próbek daje niewielki zysk. Postaw więc na próbki o różnych tematach i dołóż reguły stylu policzone na twoich wpisach.
Czy dobry prompt systemowy zastąpi humanizację tekstu AI?
Nie, prompt systemowy skraca humanizację, ale jej nie zastępuje. W teście pełny wsad dał 0 zmyśleń i dobry rytm, a mimo to każda z trzech prób zaczynała się od tego samego tiku z negacją. Takie wzorce składniowe wyłapiesz dopiero w gotowym wpisie.
Czy detektor AI wykryje tekst napisany z próbkami stylu?
Najczęściej tak. W badaniu z 2025 roku GPTZero uznawał za ludzkie zwykle mniej niż 20% prób, które modele pisały na podstawie próbek autora, i nigdy więcej niż 55%. Detektor ocenia podobieństwo do typowego wyniku modelu, więc o jakości jego werdykt nie mówi nic.
Czy humanizator AI zastąpi przygotowanie wsadu do tekstu?
Nie, humanizator parafrazuje gotową treść i nie doda faktów ani twojego głosu. Zmienia słowa i szyk pod wynik detektora, a zmyślona liczba po parafrazie nadal jest zmyślona. Wsad szykujesz przed generowaniem, parafraza wchodzi dopiero po nim.
Dlaczego teksty generowane przez AI są do siebie podobne?
Teksty generowane przez AI są podobne, bo model bez wsadu wybiera najbardziej prawdopodobne słowa i konstrukcje. Dwie osoby, które dały mu sam temat, dostają tę samą średnią z danych treningowych. Różnicę robią fakty i próbki, których druga osoba nie ma.
Czy esej akademicki napisany z AI da się przerobić tak, żeby nie było widać?
Esej akademicki podlega regulaminowi uczelni, więc najpierw sprawdź, czy i jak wolno ci w nim używać AI. Kroki z tego artykułu służą treściom, które podpisujesz jako autor i które mają nieść twoje fakty. Ukrywanie udziału modelu przed promotorem to inna sprawa i tu jej nie omawiam.