Co to jest information gain? Patent, mity i co dopisać do tekstu
Information gain, po polsku przyrost informacji, to ilość nowej informacji, którą dokument wnosi ponad to, co czytelnik zobaczył już w innych źródłach na ten sam temat. Do SEO pojęcie przyszło z patentu Google przyznanego w 2022 roku, tyle że Google nigdy nie potwierdził, że taki wynik rusza ranking.
Teraz najlepsze. Przeliczyłem top 10 dla zapytania „co to jest information gain” i wyszło, że teksty uczące przyrostu informacji same mają go mało: najlepszy zebrał 56,1 punktu na 100, a jeden z pierwszej piątki – 0,2.
Znajdziesz tu wyniki tego badania i patent rozebrany na dwie listy: co w nim jest, a czego nie ma. Na koniec dostajesz konkretną odpowiedź, co dopisać do swojego tekstu – w zależności od tego, co piszesz i ile masz na to czasu.
Najważniejsze wnioski:
- Information gain mierzy, ile nowego wnosi dokument ponad to, co czytelnik już widział, a w uczeniu maszynowym oznacza spadek entropii po podziale danych.
- Google zgłosił patent US11354342B2 18.10.2018 i dostał go 7.06.2022, a kontynuacje US11720613B2 – 8.08.2023 i US12013887B2 – 18.06.2024. Numer US9317592B1, który krąży w topie, dotyczy klasyfikacji wiadomości.
- Google nie potwierdził, że wynik information gain działa w rankingu. Patent mówi o sesji konkretnego użytkownika, a pierwsze zastrzeżenie – o automatycznym asystencie.
- W badaniu top 10 z 8.10.2026 najwięcej przyrostu informacji miał artursmolicki.com (56,1/100), a strona z pozycji 4 spadła na sam dół przez dwa twierdzenia obalone źródłem.
- 12 z 27 źródeł information gain nie pojawia się w tym topie ani razu, więc tanią przewagę dają pytania klientów, zestawienia danych i materiały do pobrania.
- Typ treści przesądza, co dopisać: matryca decyzyjna i cztery koszyki pokazują bilet wejścia, rzeczy na kilka godzin i te, na które szkoda twojego czasu.
Pojęcie jest starsze niż SEO, a jego rodowód daje najlepszą intuicję. Od niego zaczynamy.
Skąd się wzięło pojęcie: information gain w uczeniu maszynowym
W uczeniu maszynowym information gain oznacza spadek entropii, czyli niepewności zbioru danych, po podziale tego zbioru według jednej cechy. Drzewo decyzyjne przelicza ten spadek dla każdego możliwego pytania i wybiera to, po którym niepewność leci najmocniej w dół. Algorytm C4.5 Rossa Quinlana dokłada korektę i bierze cechę z najwyższym współczynnikiem przyrostu informacji (gain ratio).
Entropię podaje się w bitach. Zbiór jednorodny ma entropię 0, zbiór pół na pół – 1 bit, a przyrost informacji to różnica między entropią przed podziałem i średnią ważoną entropią grup po nim.
Policzmy to na danych umownych. Masz 10 tekstów: AI cytuje 6, a 4 pomija.
Entropia przed podziałem:
H = -0,6 * log2(0,6) - 0,4 * log2(0,4) = 0,971 bita

Pytanie A: czy tekst ma własne dane?
  tak: 5 tekstów, wszystkie cytowane    -> H = 0
  nie: 5 tekstów, 1 cytowany, 4 nie     -> H = 0,722 bita
  entropia po podziale: 0,5 * 0 + 0,5 * 0,722 = 0,361 bita
  information gain = 0,971 - 0,361 = 0,61 bita

Pytanie B: czy tekst ma ponad 2000 słów?
  tak: 3 cytowane, 2 nie  |  nie: 3 cytowane, 2 nie
  entropia po podziale = 0,971 bita
  information gain = 0
Drzewo wybierze pytanie A, bo po odpowiedzi wie o tekstach więcej. Pytanie B nie ujmuje niepewności nawet odrobinę.
W SEO mechanika jest ta sama. Jeśli po lekturze czytelnik nie wie nic ponad to, co wiedział wcześniej, dokument ma przyrost zero – choćby był długi i poprawny jak trzecia z rzędu identyczna definicja w wynikach.
W topie dla tej frazy uczenie maszynowe pojawia się w jednym pytaniu FAQ na artursmolicki.com, bez wzoru i liczb. Studocu z pozycji 9 ma notatki z teorii informacji, ale dostęp do nich jest płatny.
Do SEO pojęcie trafiło przez jeden konkretny dokument. Właśnie z nim polski top ma największy kłopot.
Patent Google o information gain: numery, daty i błąd w topie
Patent Google US11354342B2 „Contextual estimation of link information gain” przyznano 7 czerwca 2022 roku, a zgłoszono 18 października 2018 roku. Właścicielem jest Google LLC, który dostał też dwie kontynuacje: US11720613B2 (8 sierpnia 2023 roku) i US12013887B2 (18 czerwca 2024 roku).
Te same daty krążą po topie w kilku wersjach. Rozjazd bierze się stąd, że każda wersja opisuje inny etap jednego procesu:
| Etap | Numer | Data | Gdzie pada w topie |
|---|---|---|---|
| Zgłoszenie | – | 18.10.2018 | „zgłoszonego w 2018 roku” (Senuto) |
| Publikacja zgłoszenia | US20200349181A1 | 2020 | „opublikowanego w 2020 roku” (Senuto) |
| Przyznanie patentu | US11354342B2 | 7.06.2022 | „W 2022 r. Google otrzymało patent” (asystent-seo.pl) |
| Kontynuacja | US11720613B2 | 8.08.2023 | link do patentu (webmetric.com) |
| Kolejna kontynuacja | US12013887B2 | 18.06.2024 | analizy z 2024 roku (Search Engine Journal) |
| Właściciel | Google LLC | – | – |
2020 to publikacja wniosku, 2022 – przyznanie, 2023 i 2024 – kolejne kontynuacje. Nikt tu nie kłamie, każdy po prostu cytuje inny etap i nie dopisuje, który.
Z numerem patentu jest gorzej. Hasło słownikowe na arduralab.com, czyli pozycja 4 w SERP, wskazuje jako źródło patent US9317592B1 z 2014 roku i nazywa information gain sygnałem rankingowym Google.
Tymczasem US9317592B1 to patent Google „Content-based classification”, zgłoszony 29.01.2013 i udzielony 19.04.2016, o klasyfikowaniu wiadomości po słowach kluczowych. Fraza „information gain” nie pada w nim ani razu, co sprawdzisz samodzielnie w abstrakcie US9317592B1 w Google Patents.
Ten sam tekst opisuje mechanizm jako pobranie top 10–20 stron, wyciągnięcie z nich encji i twierdzeń, a potem porównanie z korpusem. Ani US9317592B1, ani US11354342B2 takiego procesu nie opisuje.
Mit
(arduralab.com): information gain to sygnał rankingowy Google opisany w patencie US9317592B1 z 2014 roku.
Fakt
Numer, tytuł i rok należą do innego patentu. Information gain opisuje US11354342B2, a Google nie potwierdził, że używa go w rankingu.
Masz już właściwy numer. Pora zajrzeć do środka – i sprawdzić, czego tam brakuje, bo ta lista waży tyle samo.
Co mówi patent, a czego nie mówi
Patent US11354342B2 opisuje system, który ocenia dokument na tle dokumentów już pokazanych konkretnemu użytkownikowi i przypisuje dokumentom jeszcze nieobejrzanym wynik przyrostu informacji. Liczenia encji, porównywania strony z top 10 ani wdrożenia w rankingu wyszukiwarki w nim nie znajdziesz.
Co jest w patencie:
- ocena dokumentu na tle tego, co użytkownik już zobaczył, a nie w próżni,
- wynik information gain dla dokumentów, których użytkownik jeszcze nie otworzył,
- model uczenia maszynowego liczący ten wynik na pełnej treści dokumentu i jej reprezentacji semantycznej (embeddingach), trenowany także na parach dokumentów ocenionych przez ludzi,
- zmiana kolejności, w jakiej system podsuwa kolejne dokumenty,
- prezentacja dokumentów przez automatycznego asystenta w odpowiedzi na pytanie zadane językiem naturalnym – o tym mówi pierwsze zastrzeżenie.
Czego w patencie nie ma:
- porównania strony z konsensusem top 10,
- liczenia encji i progów „unikalnych encji na stronę”,
- potwierdzenia, że mechanizm pracuje w rankingu Google.
Nowość mierzoną encjami i liczbami opisuje inny, starszy patent Google – US8521665B1. Branżowe hasło „policz unikalne encje względem topu” skleja więc oba dokumenty z interpretacją SEO-wców, a z samym US11354342B2 ma niewiele wspólnego.
Google nie potwierdził, że wynik information gain z patentu wpływa na ranking wyników wyszukiwania. Patent opisuje możliwość, a jego pierwsze zastrzeżenie dotyczy asystenta, nie dziesięciu niebieskich linków.
Kierunek zgadza się za to z oficjalną dokumentacją. Wytyczne Google o pomocnych treściach każą sprawdzić, czy tekst ma oryginalne informacje, raporty, badania lub analizy i czy daje coś ponad inne strony w wynikach – pisz więc pod przyrost informacji dla czytelnika, a patent czytaj jak mapę myślenia, nie jak obietnicę pozycji.
Ahrefs w artykule z 20 sierpnia 2026 roku zwraca uwagę, że system ma działać per użytkownik i per sesja i porównuje znaczenia, a nie słowa. Synonimy podmienione w cudzym tekście nie dadzą ci więc ani grama nowości.
Sesja i asystent prowadzą prosto do AI Overviews. Tam Google patrzy na fragment, a nie na cały artykuł.
Information gain na poziomie fragmentu: fan-out i AI Overviews
W wyszukiwaniu z AI przyrost informacji liczy się dla fragmentu, a nie dla całej strony. AI Mode rozbija zapytanie na zapytania poboczne (query fan-out), po czym system wyciąga pojedyncze fragmenty z wielu stron i porównuje je parami (passage-level retrieval) – tak mechanikę opisuje agencjawhites.pl.
Modele tną stronę na kawałki mniej więcej 128–600 tokenów i oceniają każdy osobno, nie patrząc na resztę artykułu. Jedna perełka gdzieś w długim tekście nie uratuje sekcji, w których siedzi wyłącznie konsensus.
Dla redakcji wynika z tego jedno: każda sekcja musi mieć własny nowy element, choćby jedną liczbę albo jeden wyjątek. Ahrefs sugeruje do tego, że w odpowiedziach AI information gain waży więcej niż w klasycznych wynikach, bo tam nie zmieści się czwarta kopia tej samej odpowiedzi.
Fragment z przyrostem informacji łatwo wziąć za fragment po prostu dłuższy, świeższy albo „unikalny” w antyplagiacie. Rozdzielmy te pojęcia raz, w jednej tabeli.
Information gain a unikalność, długość i density
Information gain mierzy nowość znaczenia na tle tego, co czytelnik już zna. Sąsiednie pojęcia mierzą coś innego: jedne pokrywanie się słów albo datę, inne objętość albo zagęszczenie faktów.
| Pojęcie | Co mierzy | Przykład | Potwierdzony czynnik rankingowy | Źródło |
|---|---|---|---|---|
| Information gain | nowość informacji względem dokumentów już obejrzanych | trzecia identyczna definicja ma przyrost bliski zera | nie, patent nie dowodzi wdrożenia | US11354342B2 |
| Unikalność (antyplagiat) | pokrywanie się ciągów słów | parafraza przechodzi antyplagiat i nie wnosi nic nowego | brak potwierdzenia w researchu | porównanie znaczeń według Ahrefs |
| Świeżość | datę publikacji lub aktualizacji | najświeższy tekst kopiujący cudze wnioski ma przyrost równy zero | brak potwierdzenia w researchu | asystent-seo.pl |
| Długość | liczbę słów | korelacja długości z cytowaniem w AI Overviews: 0,04 | nie; 53,4% cytowań trafia do stron poniżej 1000 słów | Ahrefs, grudzień 2025, za artursmolicki.com |
| Information density | liczbę faktów na jednostkę tekstu | pięć faktów w pięciu zdaniach zamiast jednego | brak potwierdzenia w researchu | artursmolicki.com |
| Fact density | trójki encja-atrybut-wartość na 100 słów | mediana 0,41 na stronach cytowanych przez AI wobec 0,15 na pominiętych | nie; to korelacja z cytowaniami w AI | Surfer SEO (Michał Suski), za katarzynabaranowska.com |
| Keyword density | udział frazy w tekście | fraza upchana w co drugim akapicie | nie; Google zaprzecza od lat | John Mueller, za katarzynabaranowska.com |
W praktyce najczęściej mylą się dwa pierwsze wiersze. Parafraza przejdzie antyplagiat i dalej nic nie wniesie, bo antyplagiat porównuje słowa, a przyrost informacji – znaczenia.
Pora na liczby. Ile przyrostu informacji mają teksty, które go uczą?
Ile information gain ma top 10 dla tej frazy – wyniki badania
W rankingu information gain dla frazy „co to jest information gain” z 8 października 2026 roku najwyżej wypadł artursmolicki.com z wynikiem 56,1 na 100. Strona z pozycji 4 w SERP zamknęła stawkę z wynikiem 0,2.
Top 10 wziąłem z Brave Search, a nie z Google, i to jest ograniczenie tego badania. Osiem tekstów merytorycznych przepuściłem przez dwie soczewki: w pierwszej model wyciągnął 162 twierdzenia, a kod policzył, które tezy ma tylko jedna strona (unikat), a które co najmniej 3 z 8 (konsensus – wyszło 18 tez).
Druga soczewka to rubryka 28 kryteriów po 0–2 punkty i tu punkt dostaje to, co tekst robi, a nie to, co radzi. Wynik końcowy to średnia obu soczewek pomnożona przez dopasowanie do intencji, minus 5 punktów za każde twierdzenie obalone źródłem pierwotnym.
| Miejsce w rankingu IG | Pozycja w SERP | Strona | Wynik /100 | Rubryka /56 | Tezy unikalne |
|---|---|---|---|---|---|
| 1 | 3 | artursmolicki.com | 56,1 | 20 | 14 |
| 2 | 1 | asystent-seo.pl | 38,1 | 8 | 12 |
| 3 | 8 | webmetric.com | 30,7 | 11 | 7 |
| 4 | 2 | senuto.com | 28,5 | 8 | 7 |
| 5 | 10 | katarzynabaranowska.com | 19,5 | 18 | 5 |
| 6 | 7 | pozycjonusz.pl | 7,6 | 1 | 1 |
| 7 | 5 | agencjawhites.pl | 5,9 | 5 | 4 |
| 8 | 4 | arduralab.com | 0,2 | 1 | 2 |
Linguee (pozycja 6) i Studocu (pozycja 9) odpadły z oceny. Pierwsza strona to słownik tłumaczeń, druga – płatne notatki.
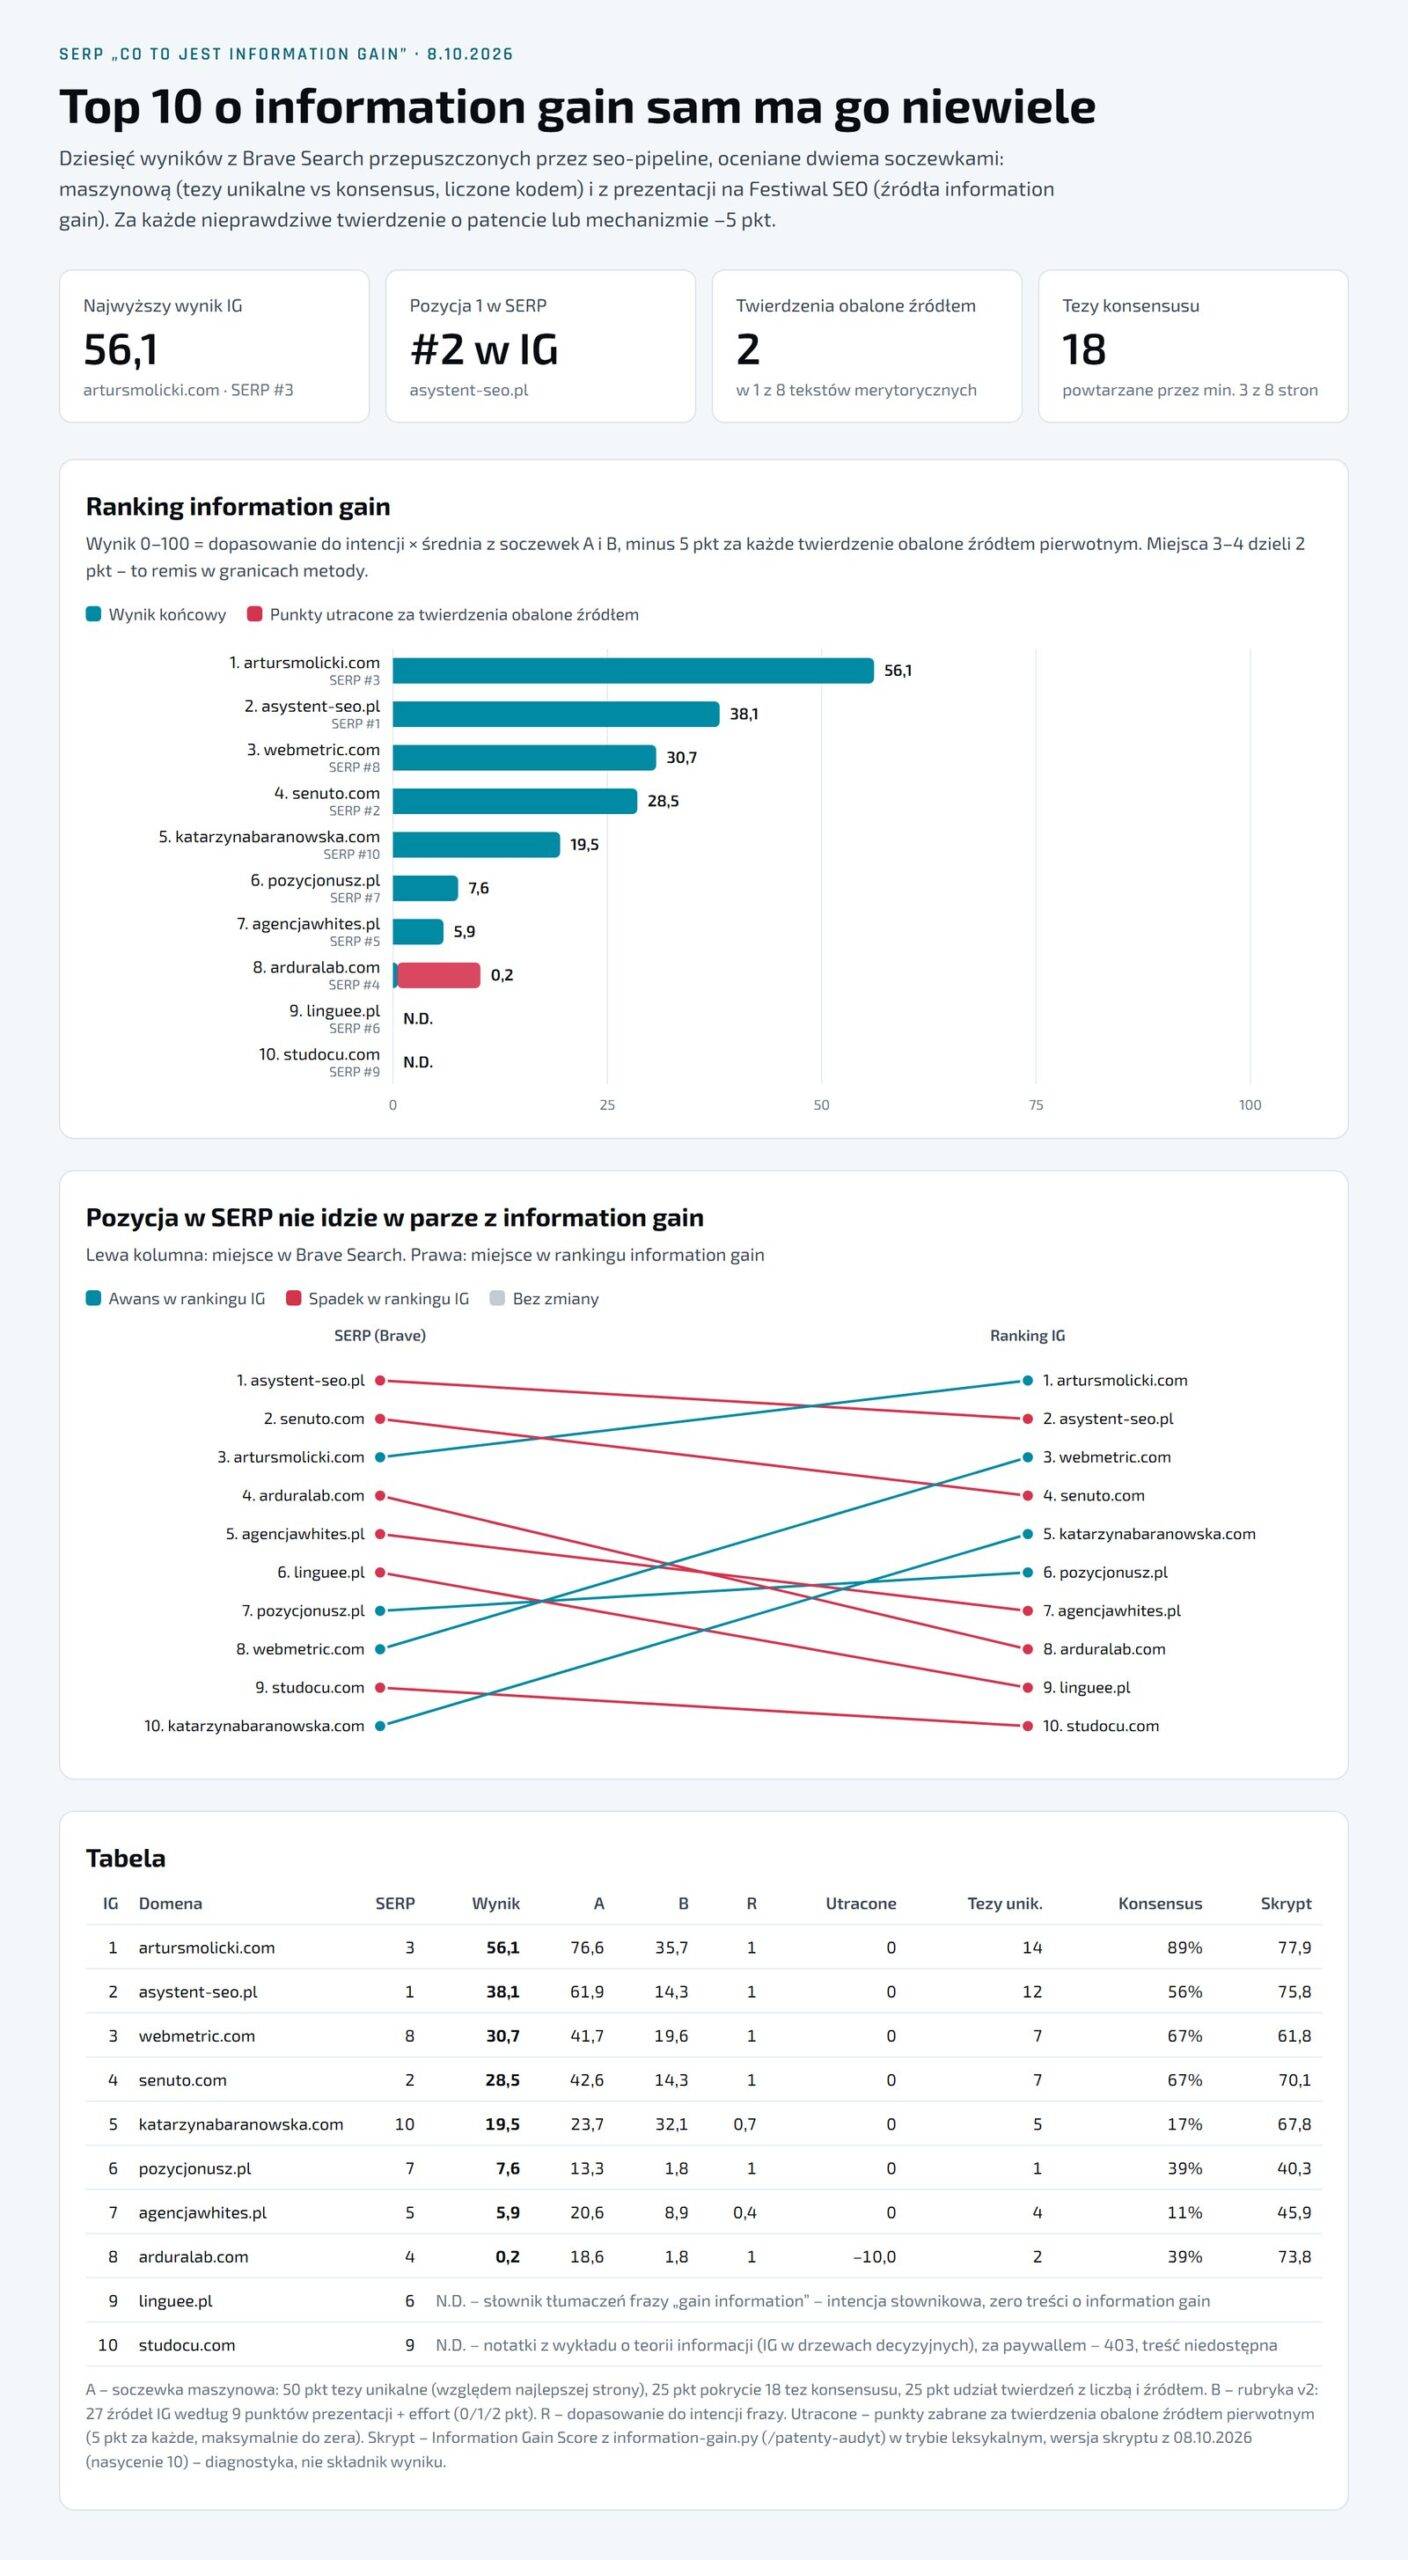
Pozycja w SERP nie idzie w parze z przyrostem informacji. Trzeci wynik w SERP jest pierwszy w rankingu IG, ósmy ląduje na trzecim miejscu, a czwarty – na ostatnim. Miejsca 3 i 4 dzielą przy tym 2 punkty, co przy tej metodzie oznacza remis.
asystent-seo.pl z pozycji 1 ma 12 tez, których nie ma nikt inny, ale trzy z nich to cudze studia przypadków (Angi, Wistia, Orbit Media) przepisane z Backlinko, a pozostałe dziewięć nie ma przy sobie żadnego źródła. Unikat z drugiej ręki szybko przestaje być unikatem.
Czytelnik nasyca się konsensusem błyskawicznie. Symulacja sesji pokazuje, że po trzech wynikach zna 17 z 18 tez konsensusu, a po czterech – komplet. Siódmy wynik daje mu już tylko 12% nowych tez.
Drugi pomiar dotyczył spójności: każdy tekst rozliczyłem wyłącznie z jego własnych rad o information gain. Z ośmiu tekstów wyszło 61 rad, które da się sprawdzić na samym tekście.
| Strona | Rady zastosowane we własnym tekście | Wynik |
|---|---|---|
| artursmolicki.com | 8 z 10 | 80% |
| katarzynabaranowska.com | 4 z 5 | 80% |
| agencjawhites.pl | 2,5 z 6 | 42% |
| senuto.com | 3,5 z 9 | 39% |
| asystent-seo.pl | 3 z 10 | 30% |
| webmetric.com | 2,5 z 9 | 28% |
| arduralab.com | 1 z 8 | 12% |
| pozycjonusz.pl | 0,5 z 4 | 12% |
Najczęstszy rozjazd? Tekst każe pokazać własne dane z GSC, GA i kampanii, a sam nie pokazuje żadnych. To miara spójności, a nie jakości – agencjawhites.pl ma 42%, bo daje mało rad, choć w rankingu IG zajmuje siódme miejsce.
12 z 27 źródeł information gain nie występuje w top 10 dla tej frazy nawet śladowo: pytania klientów, zestawienia rozproszonych danych, otwarte dane, dowód użycia, badanie, ankieta, porażki, zapytania do instytucji, antologia, kalkulator, materiały do pobrania i wystąpienie.
Skoro padło 27 źródeł, czas je wypisać. Razem z tym, jak trudno konkurencji je skopiować.
27 źródeł information gain w 9 grupach
27 źródeł information gain układa się w 9 grup i bonus: dane własne, dane zastane, grafika z dowodem użycia, badania i testy, case studies, wiedza ukryta (tacit knowledge), wywiady i instytucje, antologie, narzędzia oraz wystąpienia. Fosa mówi, jak ciężko konkurencji skopiować dany element, i jest oceną ekspercką, a nie pomiarem.
| Grupa | Elementy | Fosa | Kto to zrobi |
|---|---|---|---|
| 1. Dane własne | pomiary i dane z kont, pytania klientów | wysoka | AI pomoże, surowiec od ciebie |
| 2. Dane zastane | statystyki ze źródłem, zestawienie rozproszonych danych, otwarte dane i rejestry, dokument źródłowy czytany wprost, zmiany w czasie | niska | AI zrobi, ty sprawdzasz źródła |
| Bonus. Grafika i dowód użycia | infografika lub schemat, dowód użycia (zdjęcia, zrzuty) | niska | infografika: AI zrobi; dowód użycia: tylko ty |
| 3. Badania i testy | badanie własne, ankieta, test hands-on | wysoka | AI pomoże, surowiec od ciebie |
| 4. Case studies | case study, historia porażki, przykład przed/po | wysoka | case: AI pomoże; porażka: tylko ty; przed/po: AI zrobi |
| 5. Tacit knowledge | doświadczenie autora, wyjątki, kryteria decyzji, autorski framework, polskie realia, sprostowanie mitu | wysoka | doświadczenie: tylko ty; reszta: AI pomoże |
| 6. Wywiady i instytucje | wypowiedź eksperta, zapytanie do instytucji | wysoka | AI pomoże, surowiec od ciebie |
| 7. Antologie | zebrane wypowiedzi kilku ekspertów | średnia | AI pomoże, surowiec od ciebie |
| 8. Narzędzia i materiały do pobrania | kalkulator, quiz, konfigurator, szablon, arkusz, repo | średnia | AI zrobi, ty sprawdzasz |
| 9. Wystąpienia i nagrania | wystąpienie, wideo, prezentacja autora | wysoka | tylko ty |
AI zrobi 9 z tych 27 elementów, przy 14 pomoże, o ile dostanie od ciebie surowiec, a 4 zostają wyłącznie dla autora: doświadczenie, historia porażki, dowód użycia i wystąpienie. Jeśli tę czwórkę wygeneruje model, masz fałszerstwo, a nie przyrost informacji.
Każdy element oceniasz według jednej reguły: punkt za to, co tekst robi, a nie za to, co radzi. Akapit „dodaj dane z KRS”, w którym nie ma ani jednej liczby z KRS, dostaje zero.
Z życia wzięte
Robiłem niedawno artykuł wg tej metodyki. Dodałem parę rzeczy od siebie i po zaindeksowaniu wbił się w top 3 organika na frazę „Jak pisać z AI”. Może to chwilowy pierd Google, może podskoczy, może spadnie, ale różnicę czuć.
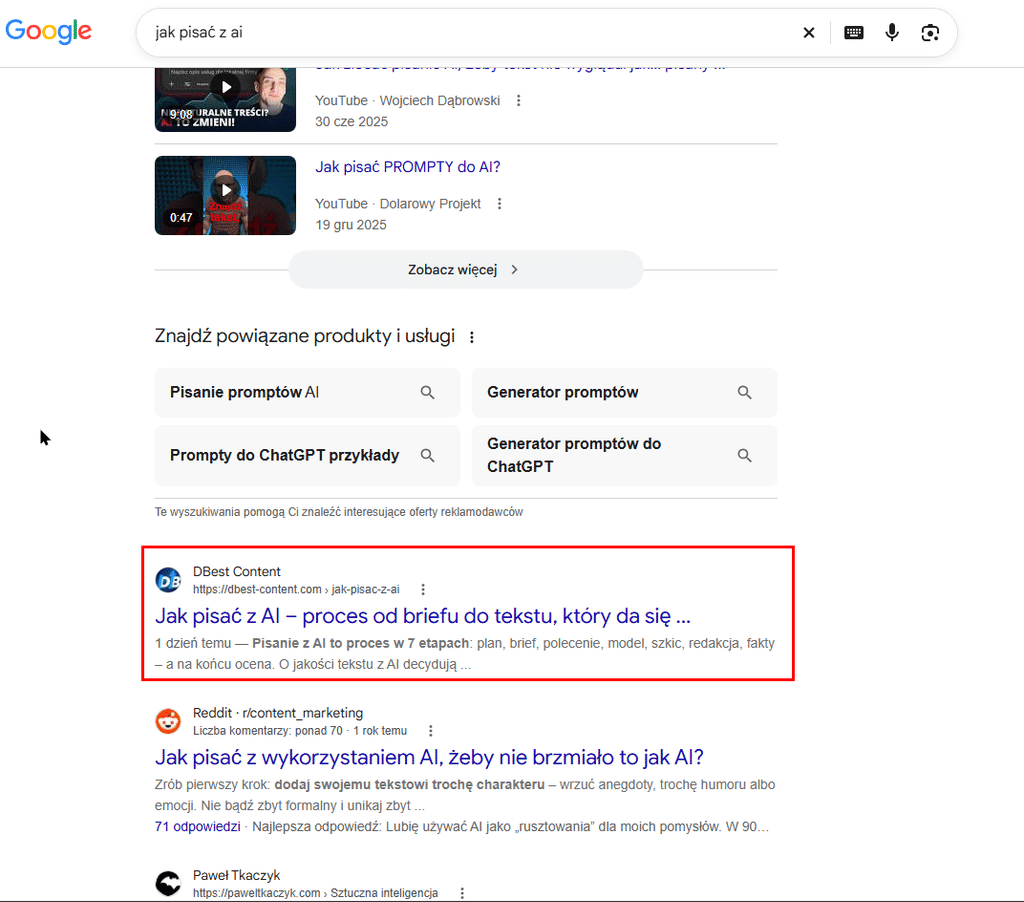
Tabela mówi, co dopisać. Jak to wygląda w jednym akapicie, pokażą przykłady.
Przykłady przed i po: ten sam akapit z przyrostem informacji
Przyrost informacji w akapicie rozpoznasz po tym, że wersja „po” mówi coś, czego czytelnik nie wyczyta z poprzednich wyników. Niżej masz trzy pary z trzech branż – nazwy firm i liczby w wersjach „po” są umowne, bo pokazują typ elementu, a nie fakty rynkowe.
1. Ubezpieczenia: udział własny w AC. Ubezpieczenia to moja specjalizacja, więc od nich zaczynam.
Przed (konsensus): Udział własny w AC to kwota, którą pokrywasz z własnej kieszeni przy każdej szkodzie. Wysokość udziału zależy od ubezpieczyciela i wariantu polisy, dlatego porównaj oferty przed zakupem.
Po (z przyrostem): Udział własny w AC to kwota, którą pokrywasz z własnej kieszeni przy każdej szkodzie. W trzech OWU położonych obok siebie wygląda to tak: Towarzystwo A – 500 zł przy każdej szkodzie, Towarzystwo B – 0 zł w wariancie serwisowym i 10% szkody przy kosztorysie, Towarzystwo C – udział rośnie do 20%, gdy prowadzi kierowca poniżej 26 lat. Ostatni zapis siedzi w paragrafie o wyłączeniach, a nie w tabeli udziałów, i to on decyduje o wypłacie.
Co tu nowego: zestawienie rozproszonych danych i dokument źródłowy czytany wprost (grupa 2, dane zastane) plus wyjątek schowany w wyłączeniach (grupa 5, tacit knowledge).
2. E-commerce: rozmiar butów biegowych.
Przed (konsensus): Dobierz rozmiar butów biegowych według tabeli producenta. Stopa puchnie w trakcie biegu, więc wybierz but o pół rozmiaru większy niż na co dzień.
Po (z przyrostem): Dobierz rozmiar według tabeli producenta, ale nie ufaj jej ślepo. W naszym sklepie 34% zwrotów butów biegowych to zły rozmiar, a najczęściej wraca model opisany jako uniwersalny, choć ma wąskie przodostopie. Na czacie co tydzień pada to samo pytanie, czy ten model nada się na szeroką stopę – weź wtedy wersję oznaczoną jako szeroka, a nie większy rozmiar.
Co tu nowego: dane własne ze zwrotów i pytania klientów z czatu (grupa 1, dane własne). Ten sam mechanizm działa w opisie produktu, co katarzynabaranowska.com pokazuje na kubku termicznym: opis bez parametrów i opis z dziewięcioma parametrami stoją obok siebie.
3. B2B SaaS: czas wdrożenia CRM.
Przed (konsensus): Wdrożenie CRM w małej firmie trwa od kilku tygodni do kilku miesięcy. Czas zależy od liczby użytkowników, integracji i jakości danych.
Po (z przyrostem): Wdrożenie CRM w firmie do 20 osób planuj na 2 tygodnie, jeśli importujesz kontakty z jednego źródła i nie podpinasz księgowości. Każda integracja z systemem księgowym dokłada 3–4 tygodnie. Wyjątek, który rozwala harmonogram: migracja z arkusza, w którym jeden klient ma kilka wierszy – deduplikacja zjada wtedy więcej czasu niż konfiguracja.
Co tu nowego: kryteria decyzji i wyjątek (grupa 5, tacit knowledge). W prawdziwym tekście te liczby muszą pochodzić z twoich wdrożeń, inaczej wiedza ukryta zamienia się w zgadywanie.
Zwróć uwagę, że każda wersja „po” startuje od tego samego konsensusu co wersja „przed”. Nowy element dochodzi do podstaw i ich nie wypiera.
Elementów masz 27, a czasu mniej, niż byś chciał. Potrzebny jest filtr i tę rolę gra matryca.
Jak wybrać, co dopisać: matryca decyzyjna i cztery koszyki
Co dopisać, rozstrzyga typ treści. Matryca zestawia 10 grup źródeł z 6 typami – poradnikiem evergreen, tematem bieżącym, YMYL, ofertą, definicją i treścią na skalę – i ocenia każde połączenie: ● pasuje i się opłaca, ◐ zależy, ○ nie pasuje albo nie zwraca kosztu.
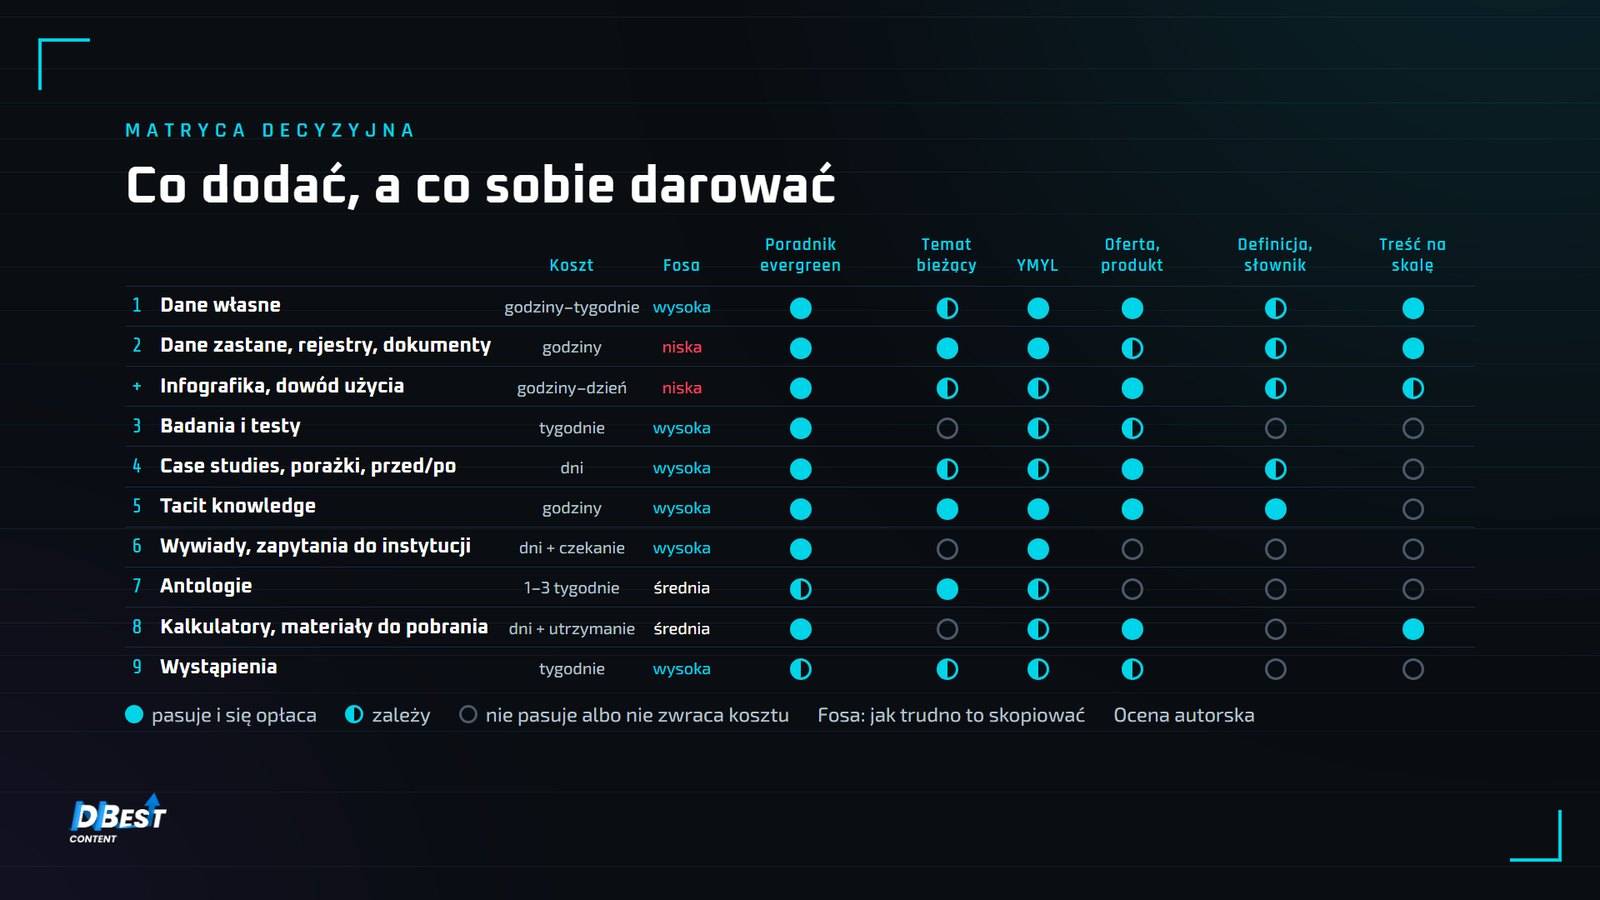
Za każdą komórką stoi powód. Badania w temacie bieżącym mają ○, bo skończysz je, gdy temat już ostygnie, a wiedza ukryta w treści na skalę ma ○, bo AI jej nie wygeneruje i przy każdym tekście potrzebujesz eksperta. Wywiady i zapytania do instytucji też odpadają przy temacie bieżącym, skoro na odpowiedź czekasz od kilku dni do kilku tygodni.
Z matrycy i z tego, co robi top, wychodzą cztery koszyki:
- bilet wejścia – element o niskiej fosie, który co najmniej połowa topu robi w pełni; zrób go, tylko nie licz na przewagę,
- łatwe – zajmie kilka godzin albo jest tani, pasuje do typu treści i ma niską fosę; bierz od razu,
- drogie, ale warto – pasuje (●) i ma średnią albo wysoką fosę; to dni lub tygodnie pracy, których konkurencja nie skopiuje,
- nie warto – nie pasuje do typu treści albo koszt się nie zwróci.
Brak zasobu podnosi koszt elementu o jeden poziom. Element z kategorii „tylko ty”, do którego nie masz zasobu, ląduje w „nie warto”, bo AI uczciwie go za ciebie nie zrobi.
Jeśli piszesz poradnik evergreen i masz tydzień, zacznij od koszyka „drogie, ale warto”: badanie, zapytanie do instytucji i rozmowę z ekspertem zamów pierwszego dnia, bo na nie się czeka. Jeśli piszesz temat bieżący, odpuść badania i wywiady, a sięgnij po dane zastane, wiedzę ukrytą i antologię komentarzy – temat ostygnie szybciej, niż odpisze rzecznik.
Jeśli piszesz YMYL, każdy element wiedzy ukrytej podeprzyj źródłem pierwotnym, a kalkulator przetestuj na prawdziwych danych, bo błąd w składce to realna szkoda czytelnika. Jeśli nie masz dostępu do pytań klientów ani własnej praktyki, nie udawaj ich z AI: przesuń te elementy do „nie warto” i dociśnij zestawienia, dokument źródłowy i dane zastane.
Umówmy się, ten tekst sam ma tu napięcie i nazwę je wprost. Zapytanie „co to jest…” wygląda w matrycy na definicję, a dla definicji narzędzia i materiały do pobrania mają ○ – jeden akapit, wyjście i żadnego konfiguratora.
Ten tekst mimo to dostaje konfigurator, bo o typie treści decyduje SERP, a nie słowa w zapytaniu. Top 10 dla tej frazy to długie przewodniki, czytelnik wchodzi po definicję i zostaje po instrukcję, co dopisać, więc w matrycy to poradnik evergreen, gdzie narzędzia mają ● – i z tego samego powodu tekst ma badanie, choć definicja dostaje przy badaniach ○.
Matrycę możesz przeczytać z tabeli albo przeklikać w konfiguratorze.
Konfigurator: co dopisać do twojego tekstu i kiedy
Zaznacz typ treści (jeden z 6 z matrycy), ile masz czasu na tekst – kilka godzin, 1–3 dni albo tydzień i więcej – jak mocna jest konkurencja w topie i jakie masz zasoby: własne dane, dostęp do pytań klientów, praktykę, eksperta do cytowania, nagrania albo wystąpienia. Konfigurator rozłoży 27 elementów na cztery koszyki i pokaże trzy, od których zaczniesz: z etapem pracy, na którym je dodać, i miejscem w tekście.
Co dopisać do tekstu i kiedy
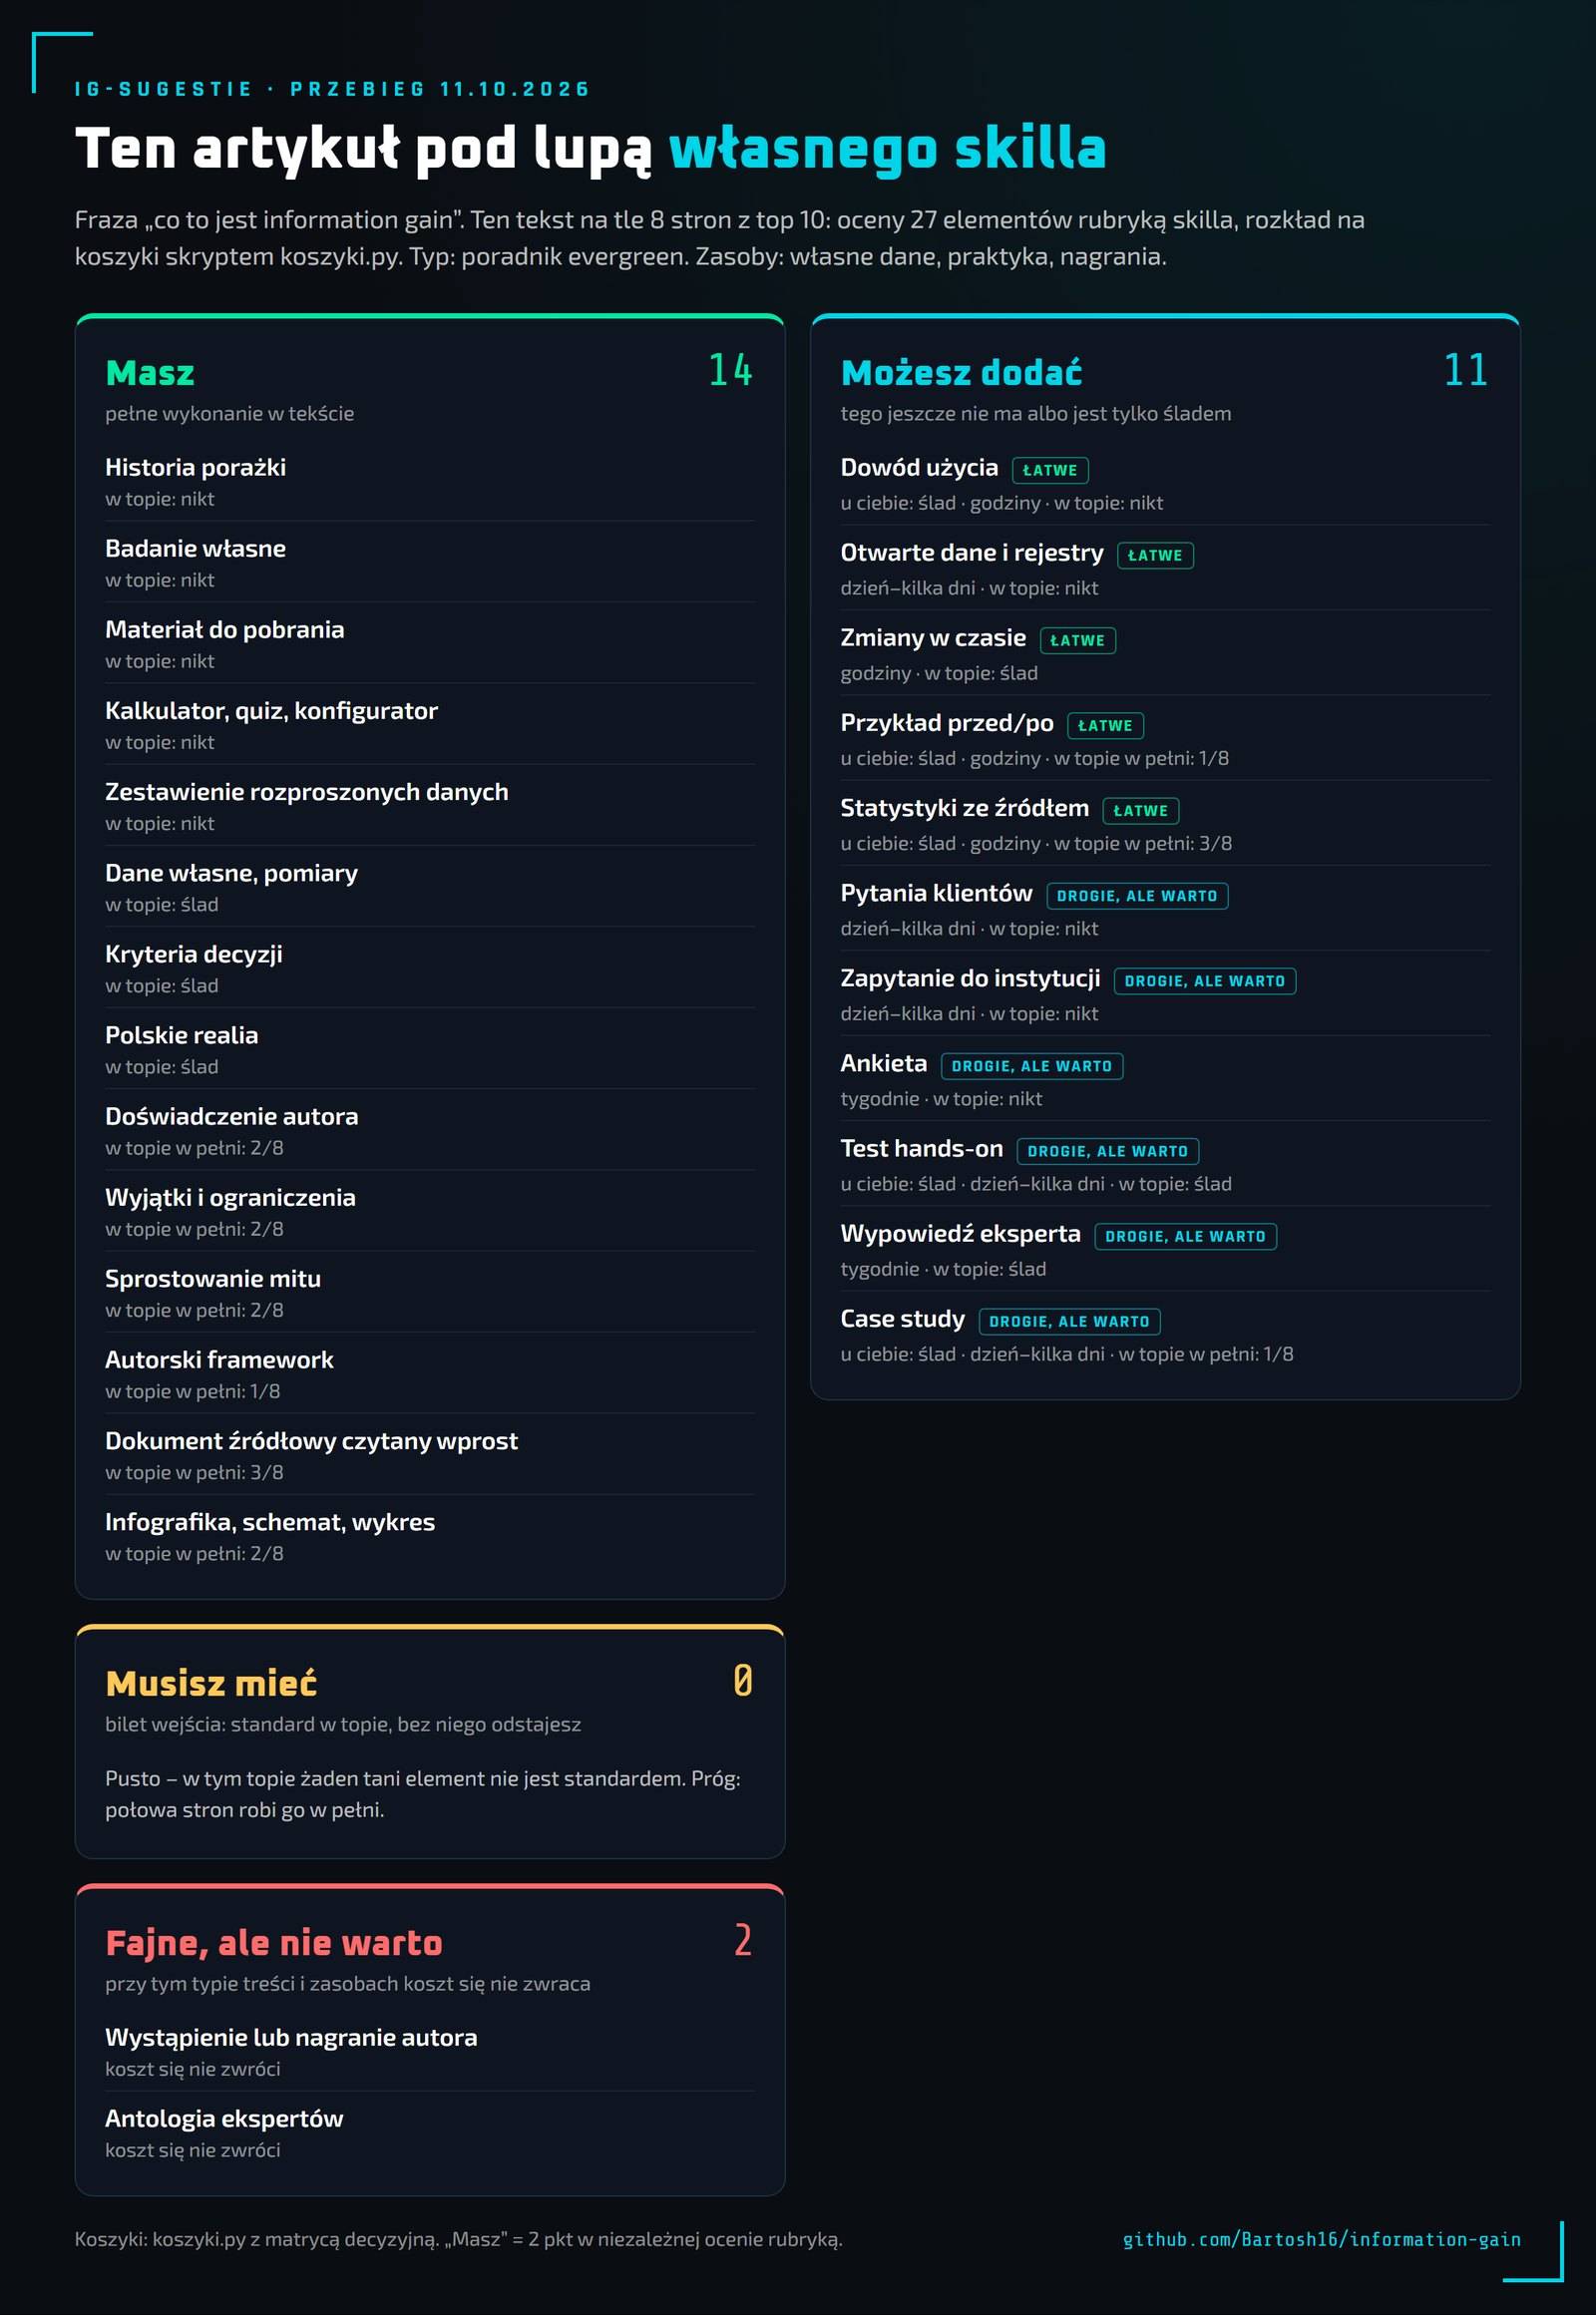
Cztery pytania. Konfigurator rozkłada 27 źródeł information gain na koszyki według matrycy decyzyjnej i wybiera trzy, od których zaczniesz – z etapem pracy i miejscem w tekście.
TOP 3Od tego zacznij
Czasem konfigurator wrzuci połowę listy do „nie warto” i oszczędzi ci tygodni pracy, która się nie zwróci. Bywa też, że nawet najlepszy element nic nie da.
Kiedy information gain nie pomaga
Information gain nie pomaga w trzech sytuacjach: przy definicjach i hasłach słownikowych, przy tematach YMYL pozbawionych kompletu źródeł i przy zapytaniach nawigacyjnych. W każdej z nich czytelnik najpierw potrzebuje konsensusu, czyli poprawnej, pełnej odpowiedzi, którą zna cały top.
- definicje i tłumaczenia: ktoś, kto wpisuje „gain information tłumaczenie”, chce dwóch słów i wyjścia – stąd Linguee w topie, a rozbudowany wywód tylko go spowolni,
- YMYL: w tematach o zdrowiu, pieniądzach, prawie i bezpieczeństwie badanie na małej próbie szkodzi bardziej niż jego brak, a sprostowanie bez źródła to ryzyko zamiast przewagi,
- zapytania nawigacyjne: ktoś szuka strony logowania albo konkretnego narzędzia, więc nowa perspektywa nic mu nie da.
Kolejność się nie zmienia. Najpierw bilet wejścia, czyli komplet konsensusu, a dopiero potem przyrost informacji – tekst złożony z samych unikatów i dziur w podstawach odpowiada na pytania, których nikt nie zadał.
Nowość nigdy nie może iść kosztem prawdy. Hasło na arduralab.com ma 2 unikalne tezy, ale za dwa twierdzenia obalone źródłem pierwotnym straciło 10 punktów i skończyło z wynikiem 0,2.
Poproś model językowy o „coś, czego nie ma w topie”, a chętnie to wymyśli. Każdą nową liczbę sprawdzaj więc u źródła, bo to te same halucynacje, które blokują pełną automatyzację treści.
Uwaga
Największą stratą czasu w moim życiu był artykuł w Rankomacie na temat wojny cenowej w OC w okolicach 2021 roku. OC było historycznie tanie, co groziło załamaniem rynku, i drastycznymi podwyżkami. Spędziłem blisko 2 miesiące, grzebiąc w danych z KNF i sprawozdaniach finansowych towarzystw ubezpieczeniowych, by na koniec „góra” przeorała 60% tekstu, poszatkowała go i wyszła z niego kupa. Artykuł miał zatrząść rynkiem ubezpieczeniowym, a przeszedł bez echa.
Przejście przez 27 elementów ręcznie, przy każdym tekście, zjada godziny. Dlatego zamknąłem ten proces w skillu.
Skill ig-sugestie: sugestie information gain do pobrania
ig-sugestie to darmowy skill na licencji MIT: podajesz frazę, a on mówi, co dopisać do artykułu, żeby wnosił coś, czego w topie nie ma. Działa w Claude Code, Codex i Cursorze, a repo leży na GitHubie: github.com/Bartosh16/information-gain.
Skill przechodzi osiem kroków:
- Rozpisuje frazę na 10–15 zapytań pobocznych (query fan-out).
- Pobiera top 10 dla każdego zapytania z twojego SERP API: SerpAPI, DataForSEO, Serpdata.io albo Brave.
- Wybiera URL-e, które wracają w topach wielu zapytań – te czytelnik zobaczy na pewno.
- Ściąga pełne treści stron, razem z FAQ i akordeonami.
- Wypisuje tezy każdej strony i liczy konsensus oraz unikaty.
- Ocenia 27 elementów w skali 0–1–2, z dowodem przy każdej ocenie.
- Skryptem rozkłada elementy na koszyki według matrycy.
- Zapisuje sugestie.md: co dodać, gdzie w tekście, kto to zrobi i ile to zajmie.
Konkurencji nie bada dla sportu i sam niczego w tekście nie dopisuje. Podpowiada, co dopisać, a pisanie zostaje po twojej stronie – podział pracy jak w innych przykładach automatyzacji contentu z AI: skrypty liczą, więc wynik da się powtórzyć, a model czyta strony i ocenia elementy z dowodem.
W Claude Code instalujesz go jako plugin. Do pracy potrzebujesz jeszcze Pythona 3.10 lub nowszego i klucza do jednego SERP API.
/plugin marketplace add Bartosh16/information-gain
/plugin install information-gain@information-gain
Slajd z mojego wystąpienia na Festiwalu SEO 2026 (23 października). Kod QR działa na sali, a na ekranie wystarczy kliknąć: github.com/Bartosh16/information-gain.
Skill odpowiada na jedno pytanie z większego procesu: co dać modelowi, żeby tekst nie wyszedł średnią z topu. Cały proces, od briefu po redakcję, rozpisałem w przewodniku o tym, jak pisać z AI.
Na koniec pytania, które po takiej lekturze padają najczęściej.
Co to jest information gain – najczęstsze pytania
Jak przetłumaczyć information gain na polski?
Information gain to po polsku przyrost informacji albo zysk informacyjny. W uczeniu maszynowym termin oznacza spadek entropii po podziale danych, a w SEO – ilość nowej informacji, którą dokument wnosi ponad to, co czytelnik już widział. Słownik Linguee tłumaczy pokrewne wyrażenie „gain information” jako „uzyskać informacje”.
Czy information gain jest czynnikiem rankingowym Google?
Brak potwierdzenia: Google nie ogłosił, że wynik information gain z patentu US11354342B2 wpływa na ranking. Patent opisuje możliwy system, a jego pierwsze zastrzeżenie mówi o dokumentach podawanych przez automatycznego asystenta. Kierunek zgadza się jednak z wytycznymi Google, które pytają o oryginalne informacje, badania i analizy.
Czy dłuższy artykuł ma większy information gain?
Nie, bo długość i przyrost informacji to dwie osobne miary. Ahrefs (grudzień 2025, dane za artursmolicki.com) policzył korelację długości tekstu z cytowaniem w AI Overviews na 0,04, a 53,4% cytowań trafiało do stron poniżej 1000 słów. Dłuższy tekst zyskuje wyłącznie wtedy, gdy dodatkowe słowa niosą nowe fakty.
Czy tekst napisany przez AI może mieć information gain?
Tak, pod warunkiem że autor da surowiec: AI zrobi samo 9 z 27 elementów, przy 14 pomoże, a 4 zostają dla człowieka. Model, któremu nie dasz danych, pytań klientów i doświadczenia, odtworzy konsensus topu. Doświadczenie albo porażka wygenerowane przez AI to fałszerstwo.
Czym information gain różni się od unikalności w antyplagiacie?
Antyplagiat mierzy pokrywanie się słów, a information gain – nowość znaczenia. Parafraza cudzego tekstu przejdzie antyplagiat i nadal będzie mieć przyrost bliski zera, bo według Ahrefs porównanie idzie po znaczeniach, a nie po samych słowach.
Jak sprawdzić information gain własnego tekstu przed publikacją?
Wystarczą trzy kroki w tabeli typu coverage matrix: wypisz tezy z top 10, oznacz te, które powtarza większość stron, i policz, ile twierdzeń twojego tekstu nie ma nigdzie indziej. Potem oceń 27 elementów w skali 0–1–2 za to, co tekst robi, a nie co radzi. Skill ig-sugestie przechodzi te kroki automatycznie i zostawia listę, co dopisać.
Czy da się dodać information gain bez własnych badań?
Tak. W matrycy tylko cztery z 27 źródeł mają koszt liczony w tygodniach: badanie, ankieta, antologia i wystąpienie. Reszta to godziny albo kilka dni – chyba że czekasz na odpowiedź eksperta czy instytucji. Najszybciej zadziałają zestawienie rozproszonych danych, dokument źródłowy czytany wprost, przykład przed/po, wyjątki i kryteria decyzji. W topie dla tej frazy zestawień nie robi nikt, a kryteria decyzji widać tylko śladowo.